Embedding Gemma Transcribe是一个独立项目,它将谷歌DeepMind的EmbeddingGemma 2——一个多模态嵌入模型——重新利用为设备端语音转文字系统。由于该模型将音频和文本置于共享的嵌入空间中,语音会落在对应文字附近。团队添加了一个小型"读取器"模型,将每个音频片段映射到文本空间中,从约229,000个英文单词中找到最接近的作为转录结果;一个微型辅助模型负责恢复标点符号和大小写。只有读取器经过训练,使用公开授权的英文语音数据在8块H100 GPU上训练不到两小时——基础模型本身从未针对转录进行微调。 最终结果是,在基础款M3 MacBook Air(8 GB内存)上通过神经引擎,大约12.6秒即可转录一小时的音频——约为实时速度的288倍,远超IBM Granite Speech(约150倍)等替代方案。其词错误率目前约为5%,而主流语音模型为2–3%;创建者认为,训练更好的读取器可以缩小这一差距。用户可以拖入音频文件,或按住右Option键在任何应用中进行听写,所有处理均在本地完成。EmbeddingGemma 2以Apache 2.0协议发布;本项目与谷歌无关联,也未获其认可。
每日HackerNews RSS
一个 Hacker News 帖子讨论了一项将谷歌的 EmbeddingGemma 2 变成语音转文字模型的实验。开发者 Shahir 解释说,他使用了共享的文本/音频向量空间:音频被编码后,再与约 22.9 万个英语词嵌入中最接近的一个进行匹配。它达到约 5% 的词错误率——这对日常使用算不错,但低于云端模型——而且速度极快(在 M4 Mac Mini 上,33 分钟文件约 6.75 秒)。他计划将其开源、增加多语言支持,并发布 TTS 版本。评论者将其与 Parakeet、Whisper、Apple 端侧、Granite Speech 和 yapsnap 进行比较,并指出其对非英语音频的局限。其他人讨论了 CTC 头、词汇泛化和 CoreML 优化。结论:这是一个很有前景的超快速本地转写概念验证,但准确率和语言覆盖范围仍需改进。
```rust ## 概述 这段 Rust 代码展示了一个编译器未能捕获的**栈内存超范围使用(stack-use-after-scope)**缺陷,该缺陷会导致未定义行为。 代码定义了一个结构体 `Q<T>`,其 `Drop` 实现会将内部的值移动到全局向量 `KEPT` 中(以 `Box<dyn Any + Send>` 类型存储)。在 `main` 函数中,创建了一个 `String` 类型的变量 `l`,并将引用 `&l` 传给了 `Q`。当 `q` 被丢弃时,该引用会被装箱并存入 `KEPT`。然而,`l` 本身会在其所在作用域结束时被丢弃,导致 `KEPT` 持有一个悬垂指针。 随后,一个新的字符串 `z` 被分配,并复用了相同的栈内存。当 `KEPT[0]` 被向下转型为 `&'static String` 并打印时,输出的却是 `z` 的内容(`"XXXX..."`),而非原始的 `l` ——这是一个典型的释放后使用(use-after-free)问题。 **预期结果:**编译器应拒绝编译此代码,因为将 `&l` 存储为 `&'static` 类型是不安全的。 **实际结果:**该程序在稳定版(≥1.85.0)及 nightly 版本上均可编译通过,并静默地产生错误输出。在 AddressSanitizer 下,程序会因 `stack-use-after-scope` 错误而崩溃,从而确认了内存安全违规。 ```
一个 HN 帖子讨论了一个新提交的、已存在 11 年的 Rust 借用检查器健全性缺陷(rust-lang GitHub issue)。一个最小安全 Rust 示例可以把非 'static 引用赋入受 'static 约束的泛型类型;自定义 Drop 实现随后可以在被引用对象释放后观察/使用它,导致释放后使用/未定义行为。评论者强调这是 rustc/借用检查器的实现缺陷,不一定是生命周期规则的缺陷,应通过拒绝该代码来修复;Ferrocene 使用相同代码,因此很可能受影响。争论涵盖 Rust 的安全承诺:一些人指出 Rust 从未声称经过形式验证,编译器/类型系统的健全性缺陷确实存在,而且它仍比 C/C++ 更安全;在 C/C++ 中,此类 UB 是程序员的责任。其他人批评 Rust 的炒作和虚假的安全感。讨论还提到形式验证、AI 辅助的缺陷发现,以及真实 crate 是否会因此损坏。总体而言:这是一个严重但可修复的编译器缺陷,凸显了 Rust 安全保证的局限,并未否定 Rust 在实践中的
``` 请启用JS并禁用任何广告拦截插件 ```
Hacker News 讨论了一篇路透社文章,该文章基于 Anthropic 的研究称,AI 模型可能很快无需数据中心即可自我复制。讨论帖意见严重分裂。怀疑者称之为反开源模型的宣传和监管俘获,认为 Anthropic 想取缔本地模型以保护自己的护城河。支持者称该研究是可信的概念验证:小型开源模型可以分片运行在廉价物联网设备上(例如 Android TV 盒子),并自主复制到有漏洞的硬件上,从而增加 AI 蠕虫/僵尸网络的风险。技术方面的反对意见指出推理速度慢、存储有限以及现有安全挑战。一些人批评最高赞评论忽视了文章;另一些人说这只是普通的恶意软件/安全问题,并非格外可怕。有几个人提到 AI 代理压垮在线系统,或需要“blue goo”防御。总体而言,该讨论帖混合了警报、轻视,以及关于开源模型竞争、安全性和 Anthropic 的警告是否自私自利的争论。
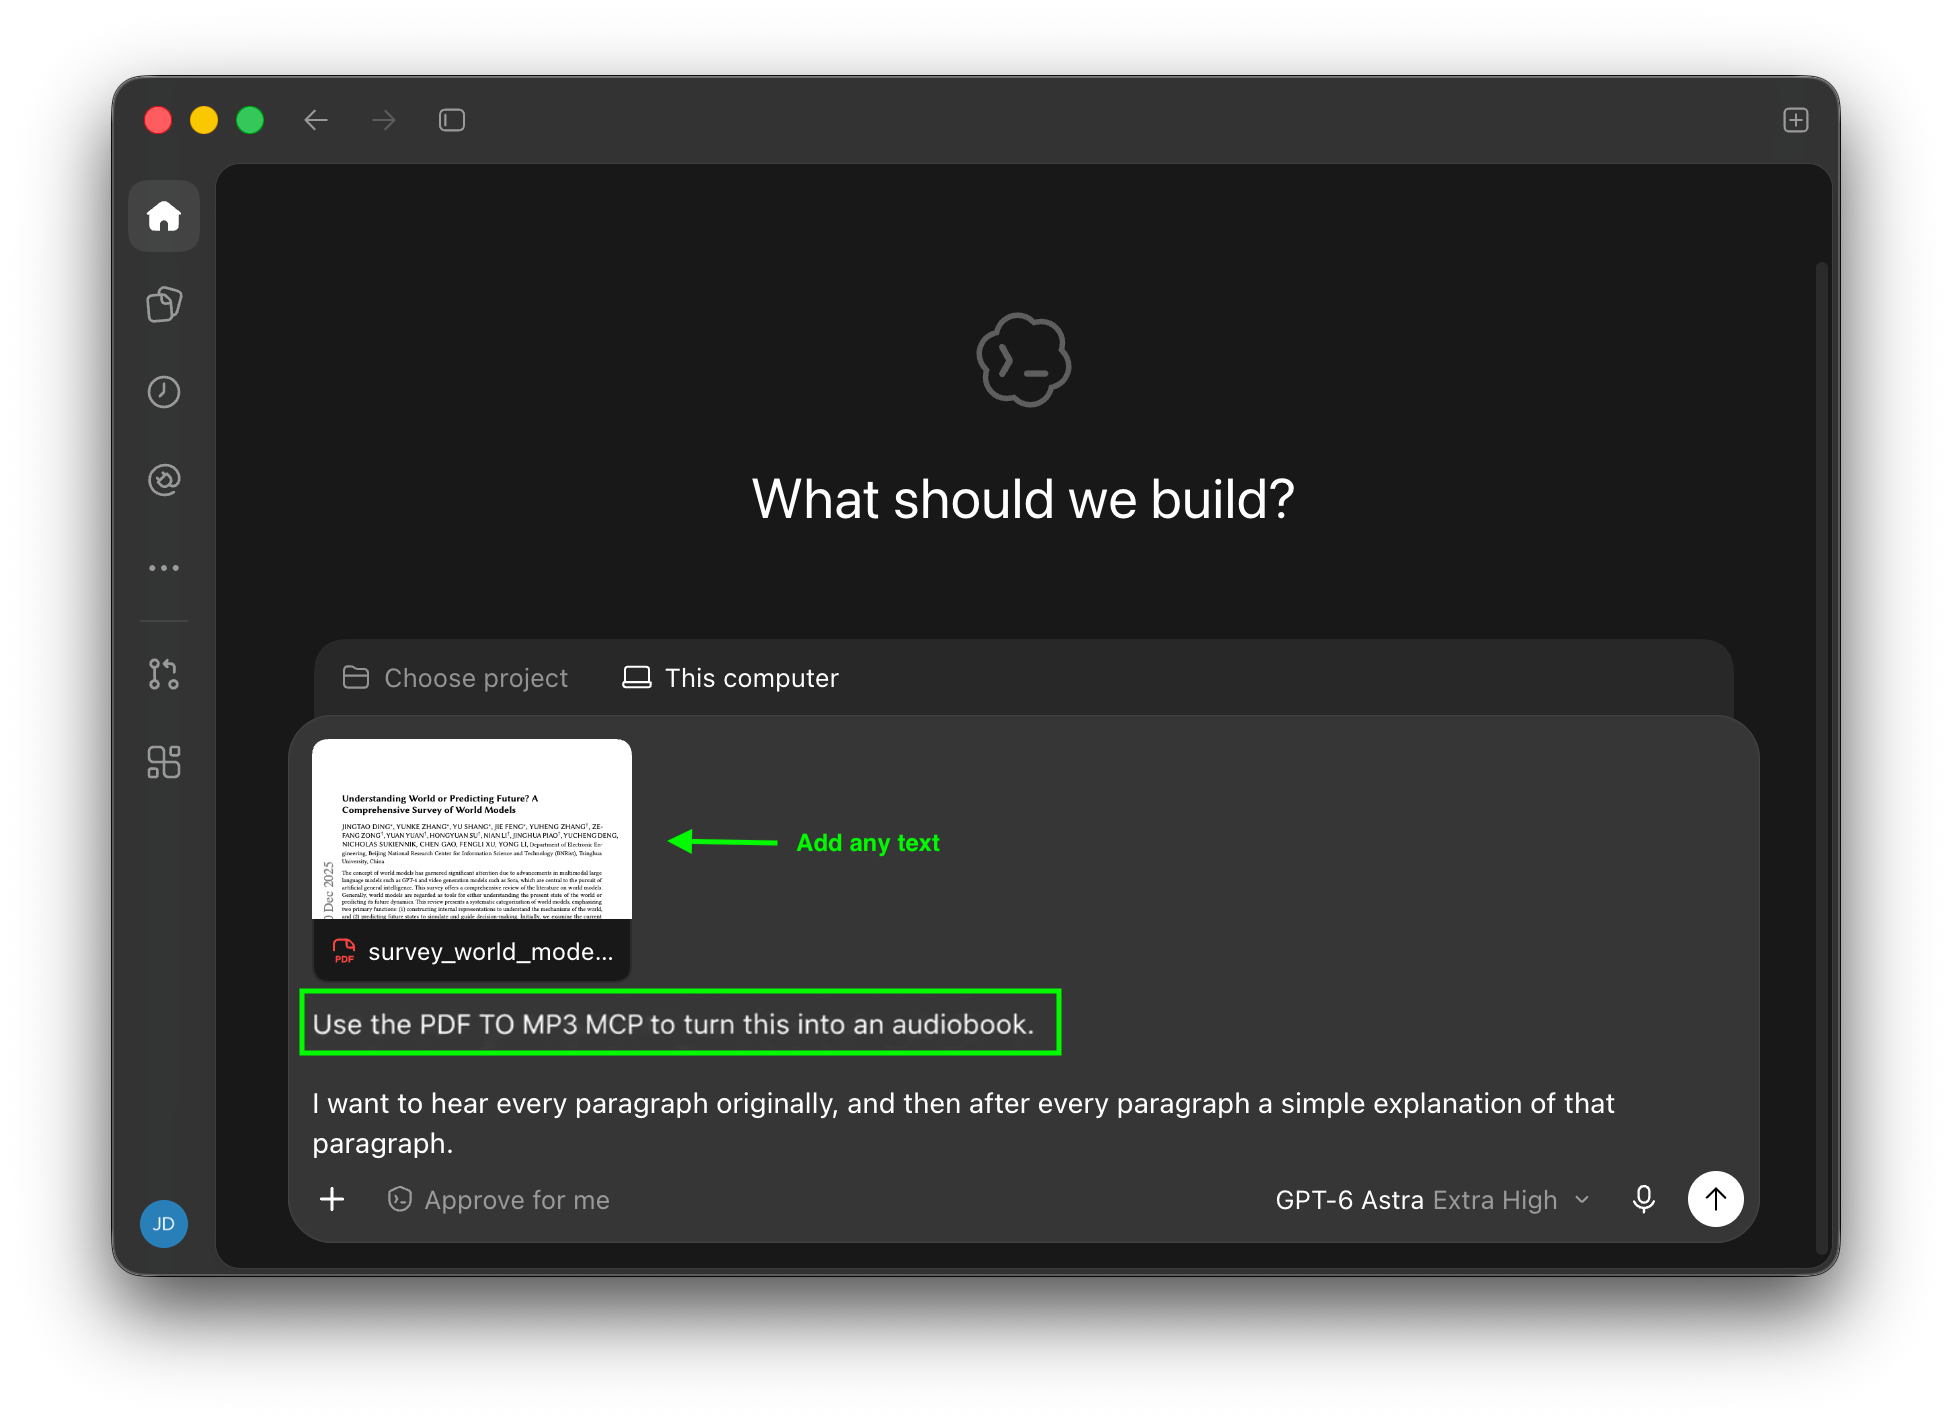 ```返回定价 $0至 PDF 转 MP3 使用您的订阅来处理文档。语音生成由 Google 或 OpenAI 计费。03发送您的第一份文档 在您的 AI 聊天中附加一个 PDF 并询问:"使用 PDF 转 MCP 将这份文档转换为有声读物。" 复制提示 您的订阅将用于:文档处理(通过 MCP)已由您的订阅支付 您的 API 密钥将用于:生成语音 OpenAI 按使用量收费 只想连接您的 API 密钥?使用我的 API 密钥 启用 JavaScript 以连接您的账户并保存一个语音密钥。```
一个 Hacker News 的“Show HN”帖子介绍了 pdftomp3.com,这是一个利用 OpenAI/Codex 订阅把 PDF 变成有声书的工具。评论者批评标题具有误导性:该订阅通过 MCP 处理文档,但用户仍需付费的 TTS API 密钥(OpenAI 或 Gemini)。安全是主要担忧,有人警告不要将 API 密钥粘贴到第三方网站,并建议使用有额度上限/会过期的密钥,或本地/开源 TTS 替代方案。许多用户分享了类似的自建流程——文章清理、TTS、RSS/播客源、ElevenLabs、Google Cloud、Kokoro、F5-TTS 等——并讨论了语音质量、发音、PDF/表格解析、许可和商业可行性。一些人称赞该工作流和示例,包括一个双人泰语播客;另一些人则将其贬为可轻易重建的封装。该讨论既反映了对 TTS 有声书自动化的兴趣,也体现了对密钥处理、营销以及免费/自托管替代方案的怀疑。
``` # 摘要:AWS Lambda Web函数 AWS推出了**Lambda Web函数**,这是一种新的形态,让开发者无需将代码重写为事件处理器,即可在Lambda上运行标准HTTP Web应用。支持Express、Fastify、Next.js或任何Node.js框架,通过单条CLI命令(`aws lambda web deploy`)即可部署,Lambda会自动处理扩展、多区域分发和计费。 Lambda现在在共享的Firecracker隔离环境上提供三种形态:**事件函数**(事件驱动,按挂钟时间计费)、**Web函数**(原生支持HTTP,每个环境最多支持128个并发请求的多路并发)和**微虚拟机**(用于不可信代码的隔离沙箱)。 Web函数的核心优势包括按活跃CPU计费——只需为实际CPU时间付费,而非I/O等待时间——这使其在服务端渲染、API后端和流式AI推理方面具有成本效益。多区域部署和基于延迟的路由会自动配置,并且支持通过版本间简单的流量切换来进行灰度发布。 Web函数还与Amazon CloudFront集成,支持源访问控制,无需自定义授权代码即可保护私有源站。 目前已在五个区域可用,运行Node.js 24,基于Arm64架构,支持VPC连接。 ```
评论者讨论 AWS Lambda Web Functions 是 AWS 对 Cloudflare Workers 和 Cloud Run 等无服务器容器平台的回应。它让开发者无需适配层就能在 Lambda 上运行标准 Web 应用,具备并发(每个环境最多 128 个请求)、活动 CPU 计费和缩容到零。它使用 Firecracker 微虚拟机,目前仅支持 Node.js,并且空闲一段时间后仍可能冷启动。
支持者喜欢部署简单、对突发/稀疏工作负载成本低,以及零服务器管理。批评者认为 FaaS 增加了本地开发、调试、监控、部署的复杂性,并可能鼓励碎片化架构;他们更偏好容器或虚拟机。其他人指出已有类似变通方案(serverless-express、Rust/Axum 适配器)和竞争对手(Cloud Run、Azure Container Apps、Vercel Fluid Compute)。
AWS 提供了示例和路线图链接,并有对更多运行时、容器和更少限制的请求。总体而言:有前景,但并未明显胜过成熟的无服务器容器。
商品期货交易委员会工作人员被告知撤回对可疑石油交易的分析报告 CFTC Staff Were Told to Retract Analysis of Suspicious Oil Trades
27 天前
彭博 需要帮助?请联系我们 我们检测到您的计算机网络存在异常活动 要继续,请点击下方的方块,让我们知道您不是机器人。 为什么会发生这种情况? 请确保您的浏览器支持 JavaScript 和 Cookies,并且您没有阻止其加载。更多信息,请查看我们的《服务条款》和《Cookie 政策》。 需要帮助? 有关此消息的查询,请联系我们的支持团队并提供以下参考 ID。 拦截参考 ID:b1468407-c6f1-11f1-9339-26a082bd60fa 订阅 Bloomberg.com,即可轻松掌握全球最重要的市场新闻。 立即订阅
彭博社的一篇报道称,CFTC工作人员被要求撤回一份对可疑石油交易的分析。Hacker News评论者将其视为机构腐败的又一迹象:该机构据称拒绝执行其职责,包括对Kalshi和Polymarket等预测市场中的体育博彩的监管,同时却代表该行业与各州对抗。他们指出,据报道,在其他委员被免职且未获替换后,CFTC只剩一位共和党主席。讨论还提到特朗普在Truth Social上就伊朗/霍尔木兹海峡问题发生反转之前的不寻常交易——大量石油和标普期货成交量在几分钟后获利——并争论这是否属于内幕交易。许多评论者绝望地认为,法律和监督被当权者无视,问责不太可能发生,选举也可能无法解决这个问题。一些人争论民主党的失败、两党制,以及腐败是否已经变得常态化。
```# 摘要:被篡改的Ledger钱包盗取1亿美元加密货币 犯罪分子正在分发经过改装的Ledger Nano X硬件钱包,旨在窃取用户的加密货币。据Tibane Labs分析,攻击者在正品设备中植入了额外硬件:一枚芯片用于拦截从安全元件芯片传输到触摸屏的种子短语,以及隐藏的LTE调制解调器、eSIM卡和天线,通过移动网络将窃取的短语发送给窃贼。钱包本身的安全芯片未被改动——攻击者只是读取屏幕上显示的内容。 区块链观察者已识别出超过300个被盗钱包,共计损失约9300万至1亿美元,资金随后通过加密货币混合器进行洗钱。 嫌疑指向Cryptobilis,一家在马来西亚和东南亚运营的钱包经销商,据称该经销商于8月秘密变更为一名叫JiaMing的人所有;其前任所有者否认与该公司有任何持续关联。Ledger已禁止该经销商继续销售,并警告从该经销商或从亚马逊日本站从中国卖家发货(实际从马来西亚发货)等转售商处购买钱包的客户,应立即将其资产转移到新钱包中。 Tibane Labs描述了三个篡改阶段,最新一代涉及专业系列制造,使设备内部看起来未被修改过。```
```
Hacker News
最新
|
过往
|
评论
|
提问
|
展示
|
招聘
|
提交
登录
网页抖动与复古着色艺术
(
maximeheckel.com
)
18 分
作者
michael-sumner
1 天前
| 隐藏
| 过往
| 收藏
| 2 条评论
帮助
ValdikSS
1 天前
| 下一条
[–]
《现代数字半色调,第二版》,作者 Daniel L. Lau、Gonzalo R. Arce,如果有人想找一本完整讲述半色调和抖动的书。
回复
ionwake
1 天前
| 上一条
[–]
很棒的博文。顺带一提,我因为在博客上使用 AI 被 HN 狠批,所以很高兴看到,区别在于把它作为一门微妙的艺术来使用才是前进之道。
编辑> 很喜欢这个网站,你的天空着色器下拉菜单在我的 MacBook Air 上不能用,最好检查一下
回复
考虑申请 YC 2027 冬季批次!
申请
开放至 11 月 2 日。
指南
|
FAQ
|
列表
|
API
|
安全
|
法律
|
申请 YC
|
联系
搜索:
```
Hacker News 上的一篇帖子链接到《教我的小妹妹如何开车》的 Steam 页面。评论者觉得它值得注意,因为据报道该游戏难以承受运营成本:每位用户都会产生 AI token 费用。随后