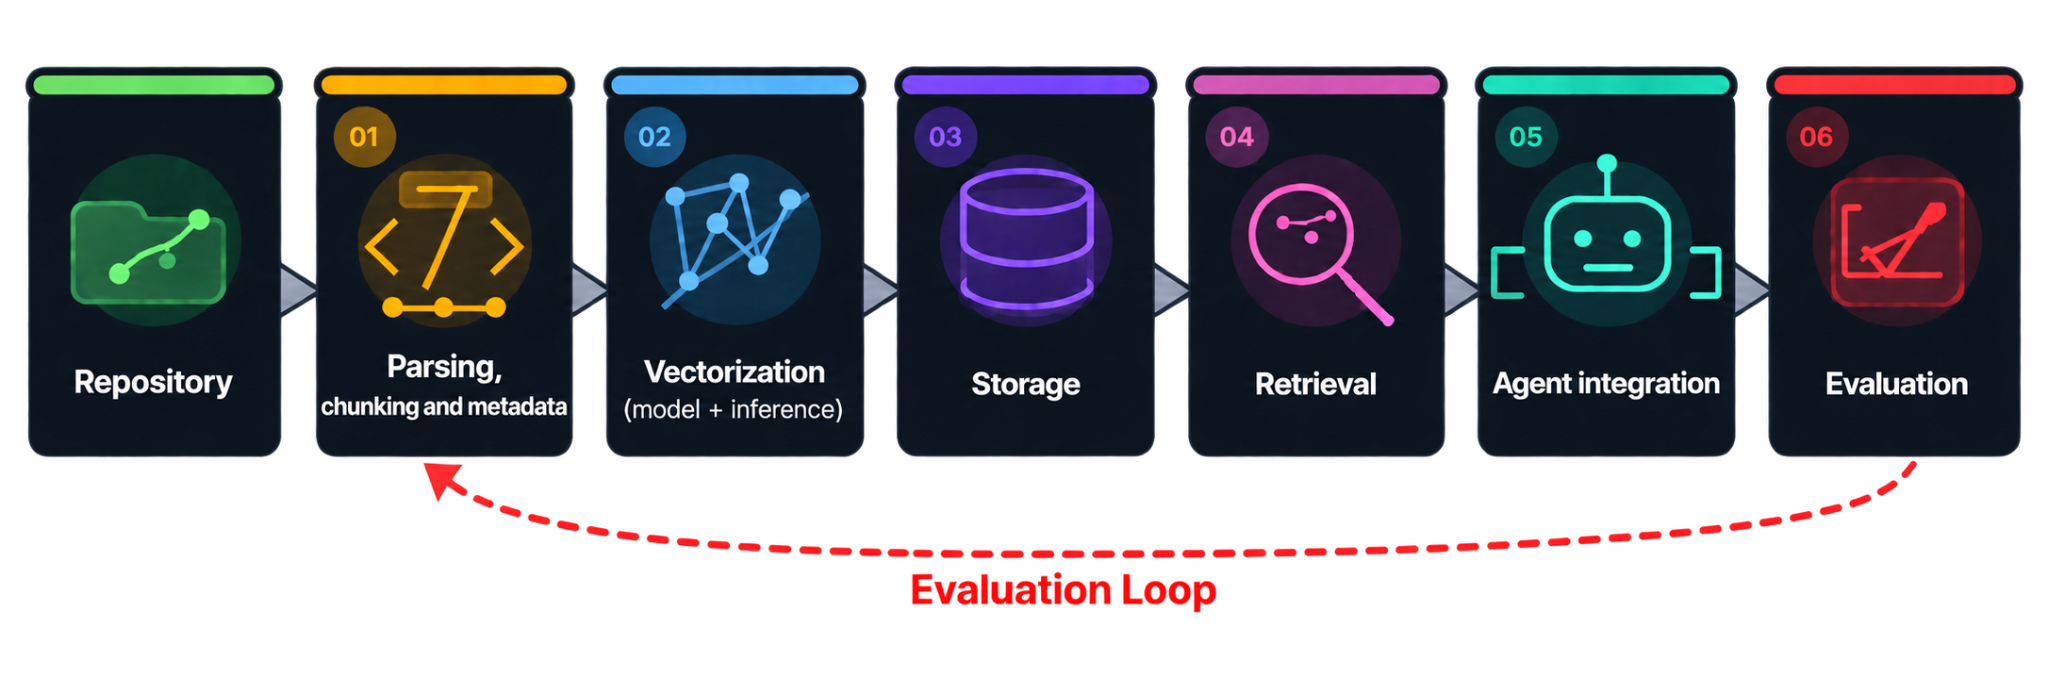
 Air Context 的生产级代码搜索 RAG 流程从解析和结构感知分块开始。JetBrains 解析器将文件拆分为语义连贯的语法单元,并保留文档、修饰符、注解和结束语法。过大的单元会被进一步拆分,较小且相关的节点则会被合并。九种语言使用专门的解析器,其他语言则回退到基于行的拆分方式。随后对分块进行规范化,并将其与相对路径配对,再通过 LLM 评审检查和端到端检索测试进行评估。
这些分块会嵌入向量模型,以支持语义搜索。Air Context 保留嵌入向量的所有维度,但将每个维度量化为 1 位,使存储量减少约 32 倍,并以汉明距离取代余弦相似度。这能够保留有用的相对排序,但会压缩分数范围,因此需要设置绝对相关性阈值的应用应使用 16 位向量。该嵌入模型同时用于高吞吐量索引和低延迟查询,查询时会附加检索指令。
长路径会被缩写,同时保留模块和文件名上下文;目录范围也会直接嵌入查询中。通过采用自托管模型、不在服务器端存储源代码,并让结果仅引用本地检出位置而非包含代码内容,从而保障隐私。
每日HackerNews RSS
 一组精选的无代码及开发者工具,用于数据可视化、仪表板和图表创建。选项包括:
- **流程图:** sankeydiagram.net、D3.js 和 xyflow(React Flow/Svelte Flow)
- **可观测性与商业智能:** Grafana、Apache Superset 和 Metabase
- **数据应用:** Streamlit
- **架构图:** Diagrams
- **交互式节点编辑器:** React Flow 和 Svelte Flow
这些工具可用于创建桑基图、自定义数据可视化、指标与日志探索、基于 SQL 的仪表板、嵌入式分析、Python 数据应用、云架构图、流程图和基于节点的界面。
Hacker News
最新
|
历史
|
评论
|
提问
|
展示
|
职位
|
提交
登录
HN 展示:每日数据可视化项目排名,来源于 GitHub、NPM、PyPI 和 CRAN
(awesomedataviz.com)
11 分
由 javierluraschi 发布
1 天前
隐藏
|
历史
|
收藏
|
1 条评论
帮助
nippoo
1 天前
[–]
你应该自己撰写 HN 帖子,而不是使用大语言模型——一眼就能看出来,而且会让人反感。
回复
考虑申请 YC 2027 年冬季批次!
申请截止至 11 月 2 日。
指南
|
常见问题
|
榜单
|
API
|
安全
|
法律条款
|
申请加入 YC
|
联系我们
搜索:
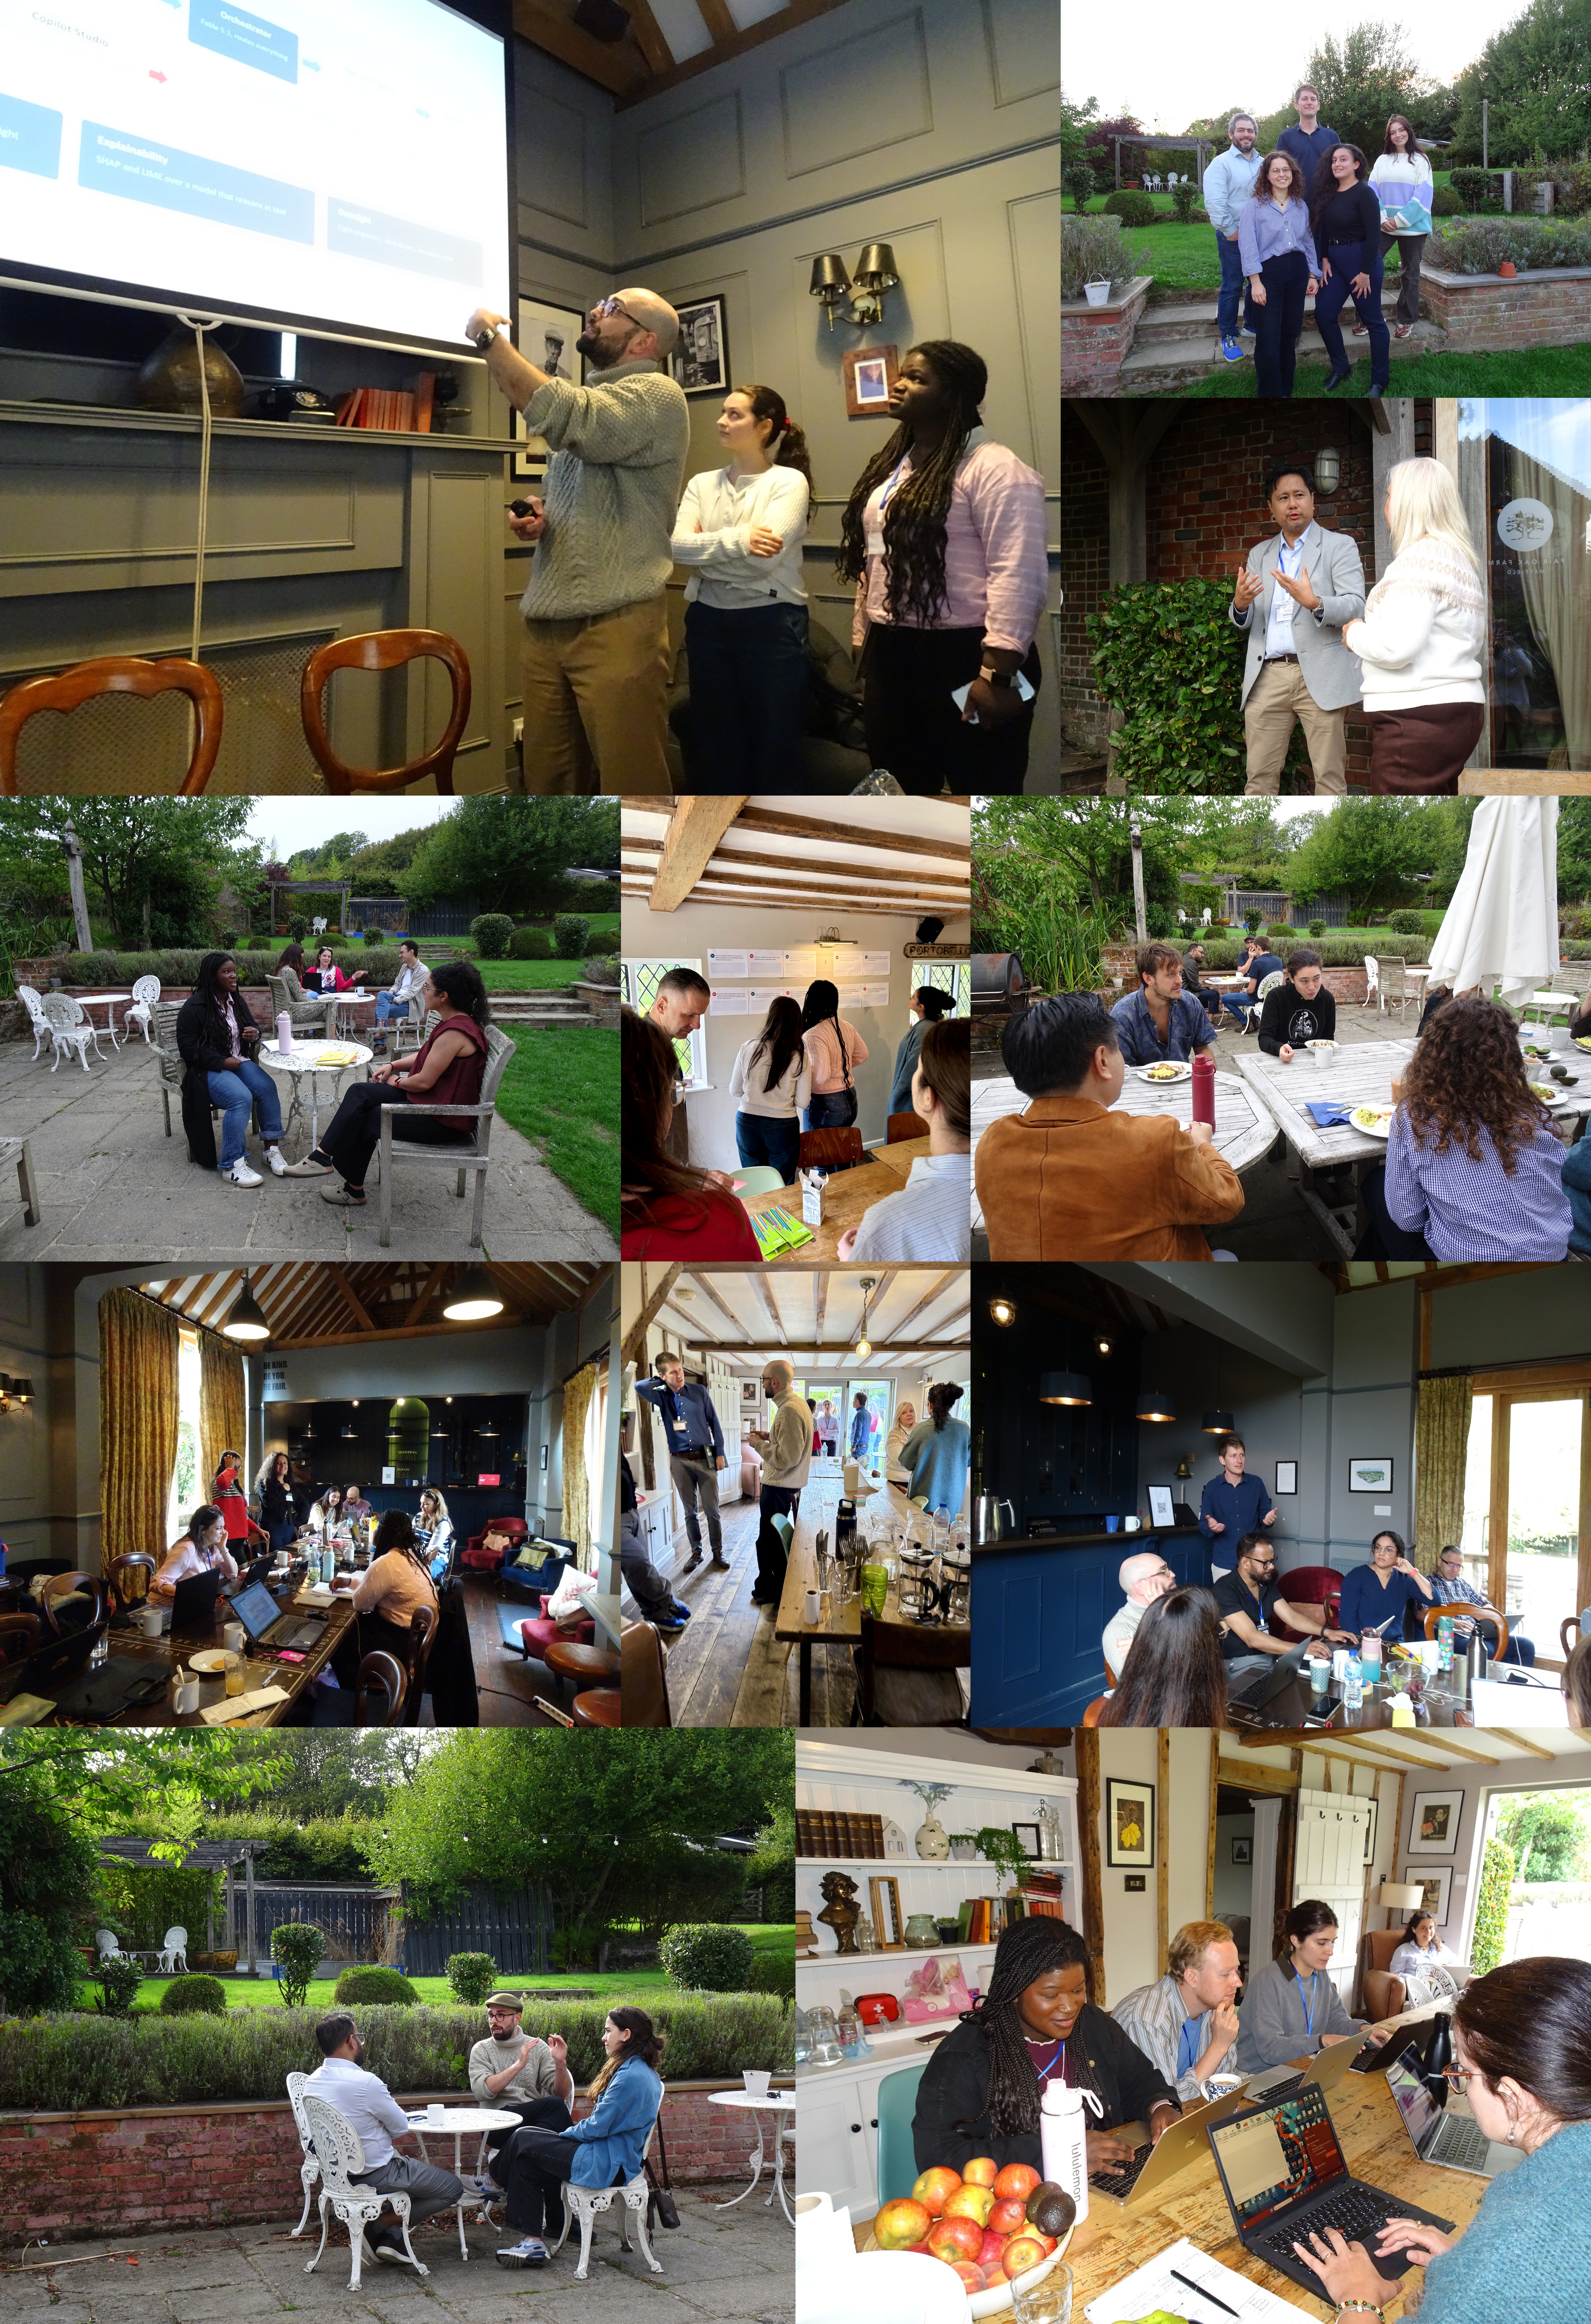 文章指出,尽管人们对人工智能安全的政治支持日益增强,但当前的落实工作很大程度上取决于市场激励,以及那些能够将技术风险转化为合同条款、采购流程、治理机制和政策建议的专业人士。律师、合规专家、风险管理人员和负责任人工智能从业者,往往既缺乏足够的技术知识,也缺少能够提供支持的同行社群。
在东萨塞克斯郡举行的一场为期五天的 ML4Good–EquiStamp 研讨会,汇集了来自12个司法辖区的19名高级法律、治理和风险专业人士。课程涵盖前沿模型训练、评估、智能体、安全保障措施和安全研究。参与者表现出浓厚的学习意愿,也非常重视与面临类似挑战的人建立联系。
活动结束后的几天内,与会者便开始采取实际行动:质疑供应商对安全性的宣称、审查人工智能智能体、招募相关领域的专家、在内部分享知识,并寻求更有力的政策参与。这些初步成果进一步印证了文章的核心观点:人工智能安全工作必须走出研究人员和前沿实验室,进入更广泛的组织之中,因为正是这些组织的采购和部署决策塑造着整个生态系统。作者希望为紧邻人工智能技术开展工作的法律和治理专业人士建立一个长期持续的社群。
彼得·沃茨于2006年出版的硬科幻小说《盲视》(*Blindsight*)讲述了星际飞船“忒修斯号”的船员故事。他们奉命调查伯恩斯—考菲尔德彗星发出的外星无线电信号。任务途中,他们抵达“大本钟”,并遭遇名为“罗夏”的巨大外星结构。这个结构似乎拥有智能,却不具备意识,其中的居民“争夺者”智力极高,同样没有自我意识。经过探索与冲突,“忒修斯号”为摧毁罗夏而牺牲,叙述者 Siri Keeton 则逃脱并返回地球,带回重要信息。 小说探讨了智力与主观体验之间的区别,追问意识是否是交流、共情、艺术或道德行为的必要条件。作品还涉及进化、神经科学、人工智能、自由意志、博弈论和超人类主义,并提出:意识或许是一种进化负担,也或许只是人类暂时拥有的优势。 《盲视》获得了星云奖,并入围雨果奖、坎贝尔纪念奖和罗克奖。其2014年衍生前作为《Echopraxia》。该小说采用知识共享许可协议发布,也已被改编为短片,长篇电影则处于筹划阶段。
该网站正在使用安全服务保护自身免受网络攻击。您刚才执行的操作触发了此安全措施。多种操作都可能导致拦截,包括提交特定单词或短语、SQL 命令或格式错误的数据。
 这篇文章介绍了斐波那契 L 系统。这是一组替换规则——\(b \rightarrow a\) 和 \(a \rightarrow ab\)——用它生成的字符串中,各符号的出现次数遵循斐波那契数列。文章从经典的兔子繁殖问题谈起:幼兔经过一个月成熟,成年兔子此后每个月都会生下新的幼兔。
这些简单的规则还能生成有趣的模式,例如越来越复杂的象鼻虫名称,如“Zyzzyzyva”;披萨配料名称,如“peppepeppeppepperoni”;以及家庭称谓,如“Grandmammamammamma”。作者还指出,要生成准确的家庭称谓,需要跳过内部的一个“a”,而其他变体则被有意留作探索。总体而言,本文轻松地展示了一个简洁的重写系统如何产生斐波那契式增长,以及越来越长、令人难忘的词语。

奶沫咖啡 Caffè Corretto
39 天前
Caffè corretto 是一种意大利咖啡,由一份意式浓缩咖啡和少量烈酒混合而成,烈酒通常使用格拉帕、桑布卡、白兰地或干邑。点单时通常会说是 *un caffè corretto alla grappa*(加格拉帕)、*alla sambuca*(加桑布卡)或 *al cognac*(加干邑)。烈酒可以直接混入浓缩咖啡,也可以另外放在旁边,让饮者自行决定加入多少。 “Corretto”在意大利语中意为“修正的”或“改正的”。类似的咖啡加烈酒饮品包括西班牙的 carajillo、葡萄牙的 café com cheirinho、法国 的 café-calva,以及墨西哥的 café con piquete。在意大利威尼托地区,*rexentin* 的传统做法是用饮料中的烈酒冲洗杯中剩余的咖啡,然后将咖啡喝掉。
点亮世界…… 地球 河流 脉动 闪电 降雨量 紫外线 影片 博客 关于 世界灯塔 地球上每一座已标注的灯塔,均按其真实周期闪烁。 苏格兰 布列塔尼 新英格兰 日本 挪威 开普敦 - + 点亮世界……
 首项大规模研究考察了联网汽车生态系统中的隐私问题。互联网汽车会与制造商、广告商、保险公司及其他第三方通信。研究人员与《消费者报告》合作,测试了21款较新车型和30款配套移动应用。结果发现,21辆车中有19辆会向至少一个第三方发送数据,7款应用会向外部公司传输敏感标识符。该研究凸显了消费者对这类数据共享活动的了解有限,并强调有必要持续开展监测、加强监管以及提供更清晰的隐私保护。