这篇文章展示了如何将现成的 LLM(如 GLM-5.3-Flash)转化为高效的“决策模型”,且无需进行微调。 该方法不再生成全文或 JSON,而是通过提示词引导模型输出一个代表预定义选项的单一索引。系统通过在单次前向传递中分析这些特定 token 的对数概率(log probabilities),即时输出类型化的决策结果及置信度分数。 **核心亮点:** * **性能:** 在 28 个数据集的基准测试中,该方法的准确率和速度均与 TypeSafe 的 Jev 等专用决策模型相当。 * **多模态能力:** 与 Jev 不同,该方法利用模型的视觉能力,实现了针对图像(如扫描文档)的类型化决策。 * **高效性:** 避免了生成式任务的开销,系统实现了亚秒级的低延迟,适用于高吞吐量应用。 * **安全性:** 通过“私有模式”(Privatemode)运行,这些决策在机密计算环境中处理,确保数据在推理过程中始终保持加密状态。 该方案开源并兼容任何基于 vLLM 的端点,为传统的专用决策软件提供了一种灵活且高性能的替代方案。
每日HackerNews RSS
近期的一场 Hacker News 讨论探讨了一种利用 GLM-5.3-Flash 等标准大模型实现“类 Jev”性能(即快速、单次决策)的方法。通过精心设计提示词,使模型输出的第一个 token 即为答案,开发者能够模拟出专用模型的决策速度。
支持者认为,该方法在准确率上具有竞争力,且与 Jev 不同,它还增加了对视觉输入的支持。此外,它还允许进行开源权重自部署,这对合规性至关重要,并避免了对不透明的专有 API 的依赖。
然而,社区对此仍存在分歧。批评者认为,这些“类 Jev”技巧本质上只是经过精心调优的分类提示词,开发者多年来一直都在使用。虽然该方法成功降低了延迟,但怀疑论者坚持认为,Jev 的架构(可能涉及非自回归模型或专用分类器)在规模化应用中依然在速度和成本效益上具有固有优势。
这场讨论凸显了一个更广泛的趋势:行业正从单纯的生成式大模型任务转向针对业务自动化优化的、高速的分类器。许多参与者对“Jev”的频繁宣传感到厌倦,认为这可能只是一种营销手段(即“虚假草根营销”),而该任务实际上完全可以使用现有的开源工具轻松实现。
HomeBody:一个能够自主探索、记忆并采取行动的人形机器人 HomeBody: A humanoid that explores, remembers, and acts on its own
49 天前
HomeBody 是一个通过“空间目标”连接任务推理与物理执行的机器人框架。系统通过选择技能及其对应的目标(源自第一视角图像、地图上下文及末端执行器状态)来触发结构化的工具调用。这种机制将视觉语言模型(VLM)与底层实现解耦,因为各项技能可自行管理运动规划。 每项技能都使用针对其功能定制的空间输入: * **抓取 (Picking):** 利用二维图像坐标引导分割和立体深度估计,随后进行分析性抓取预测及具备避障功能的运动规划。 * **导航 (Navigation):** 依赖二维地图坐标和方向目标。 * **放置 (Placing):** 执行朝向相对于机器人躯干的三维释放目标的运动。 * **操作 (Manipulation):** 将诸如抽屉开启等复杂任务,整合为包括对齐、钩挂和拉动在内的一系列统一动作。 通过将物理执行与高层推理抽象分离,HomeBody 使视觉语言模型能够在无需了解底层控制细节的情况下,指挥复杂的多步机器人行为。
Hacker News 上近期的一项讨论介绍了由斯坦福大学开发的类人机器人“HomeBody”。该机器人能够自主探索、记忆并执行任务。该系统基于宇树科技(Unitree)的 G1 机器人,并搭载 GPT Astra,使其能够根据用户需求完成清洁和取物等家务。
这一消息在用户中引发了褒贬不一的反应。一些人对机器人承担家务的未来感到兴奋,而另一些人则对就业市场的影响表示担忧。关于“自主”的定义也引发了争论:支持者认为机器人无需人类直接引导即可执行任务,但怀疑论者指出它依然依赖于软件驱动的指令,认为“独立”一词或许言过其实。总体而言,该讨论反映了人们在技术乐观主义与对先进机器人技术的实际应用及社会影响的担忧之间所持的复杂心态。
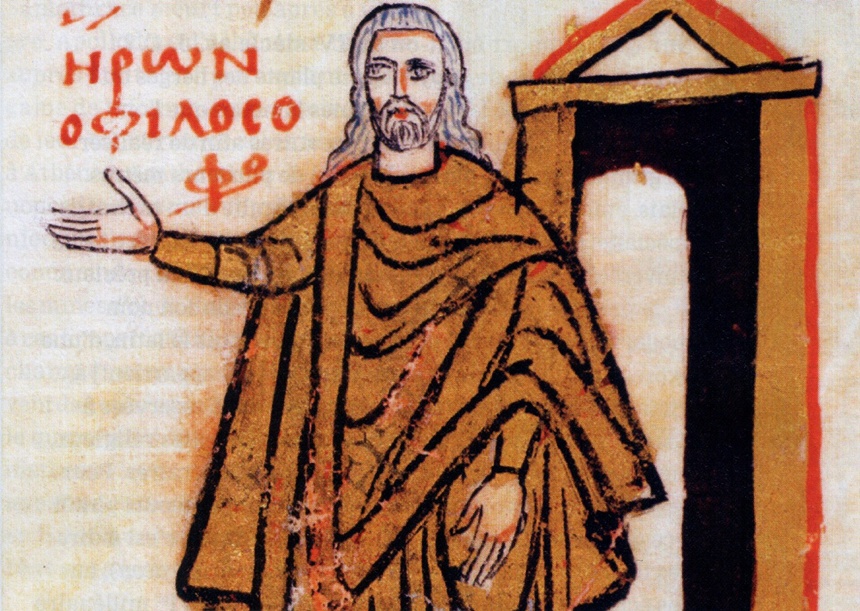 虽然现代自动售货机已成为日常生活的一部分,但其起源可以追溯到古罗马时期的埃及。最早的自动化设备由亚历山大的希罗(Hero of Alexandria)发明,他利用投币式的天平和杠杆机制在神庙中分发圣水。
几个世纪后,到了17世纪,自动售货技术在英国重新出现,用于销售烟草。19世纪末,该行业开始蓬勃发展,早期的美国创新者如托马斯·亚当斯(Thomas Adams),开始在纽约的铁路站台上使用机器销售口香糖。整个20世纪,机器经历了显著的演变,从销售香烟、咖啡到冷藏三明治,功能日益多样。
技术的进步,特别是从单纯的投币操作转向纸币扫描,以及最终实现信用卡和数字支付的整合,彻底改变了该行业。如今,自动售货市场已是一个价值数十亿美元的企业,并采用了触摸屏和人脸识别等先进功能。从简单的分配器到提供美食和新鲜农产品的复杂智能终端,自动售货机已从古代的奇珍异物演变为现代商业中必不可少的高科技工具。
这篇 Hacker News 讨论探讨了自动售货机的现状与商业现实。参与者们分享了对这些机器日益复杂化的观察——从日本和中国先进的机械臂,到新型号中读卡器不可靠及计划性报废等问题。
讨论的很大一部分集中在商业层面,起因是一位用户对自动售货机作为“被动收入”来源的好奇。经验丰富的评论者迅速驳斥了这一观点,指出该行业属于劳动密集型,需要库存管理和设备维护方面的专业知识,且竞争极其激烈。用户指出,获得高人流量的经营点位非常困难,因为这些点位通常被老牌运营商、要求支付租金的业主或(在历史上)有组织犯罪集团所控制。总而言之,这篇帖子为那些美化自动售货机生意的人提供了一个务实的现实检验,同时也突显了这些设备在技术上的极端演变。
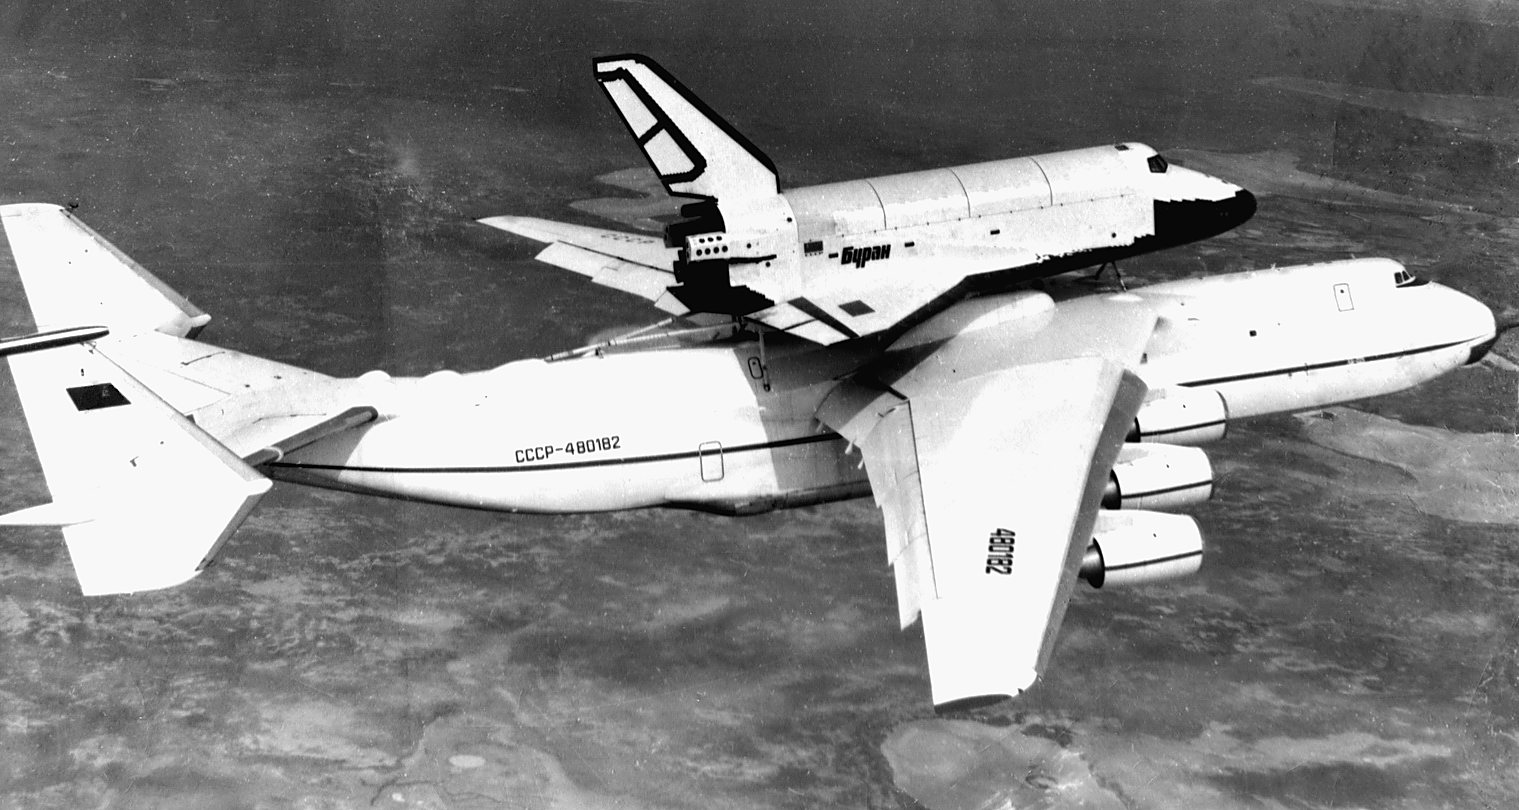 本文探讨了苏联“暴风雪”号航天飞机的四通道冗余系统,该系统利用四台运行相同软件的“Biser-4”飞行计算机,以实现对两次同步故障的容错。作者明确指出,这并非“3f+1”拜占庭容错方案,而是一种通过比较输出结果来识别并屏蔽故障通道的输出表决系统。
作者指出,在所有通道上运行相同的软件会带来“共模故障”的风险,即共享的软件漏洞可能导致所有计算机产生相同的错误输出,航天飞机(Space Shuttle)和阿里安501(Ariane 501)火箭均曾因该漏洞遭受重创。
为了探索这一问题,作者使用 Rust 语言实现了一个表决组件,并利用 Lean 4 定理证明器对其正确性进行了机器辅助形式化验证。尽管证明确保了表决器本身不会发生崩溃且能正确屏蔽单点故障,但它无法检测或防止共享的软件缺陷,也不是符合 DO-178C 等行业标准的完全合格工具。文章最后总结道,形式化验证虽是确保关键系统可靠性的有力手段,但它只是对严谨软件设计和系统级故障防护的补充,而非替代。
对不起。
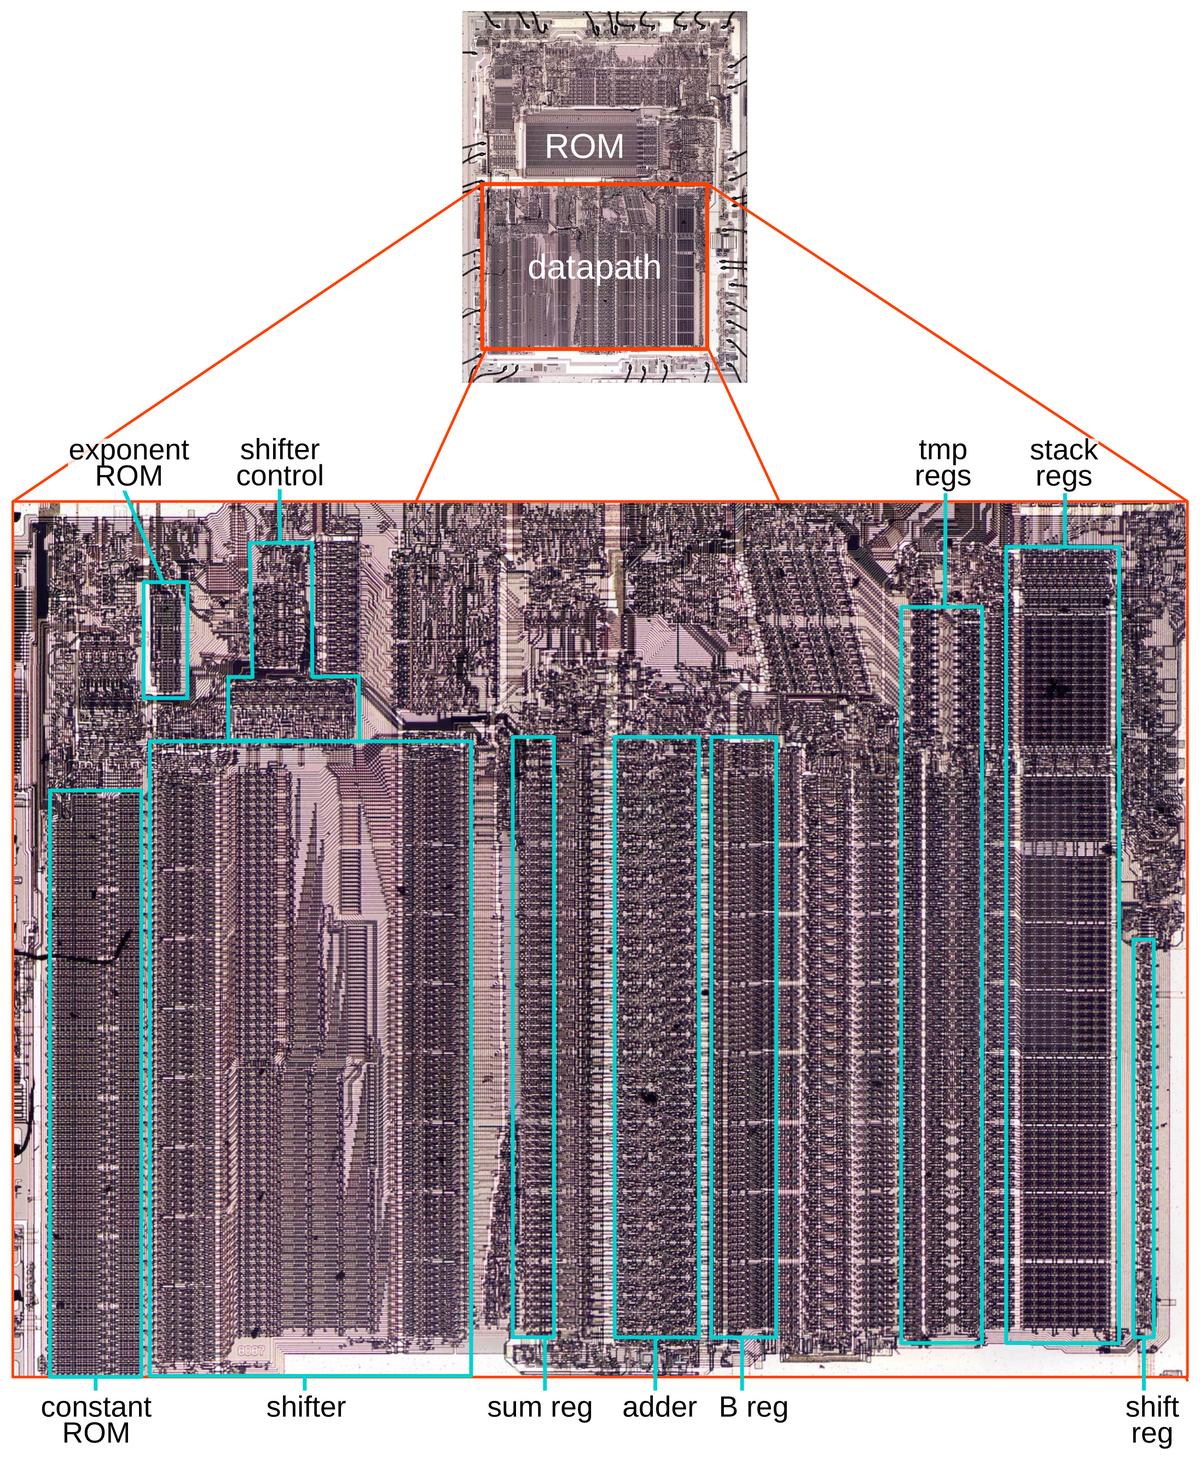 1980 年推出的英特尔 8087 处理器通过大幅加速浮点运算,彻底改变了 IBM PC 的性能。其一大亮点是 `FPTAN` 指令,仅需 90 微秒即可完成正切计算,相比 8086 处理器所需的 13,000 微秒有了巨大提升。
为了实现这一性能,8087 采用了结合 **CORDIC**(坐标旋转数字计算机)算法与**有理多项式近似**的复杂混合算法。CORDIC 最初是为 B-58 轰炸机开发的,它允许仅通过简单的加法、减法和位移运算来计算超越函数,从而避免了昂贵的乘法或除法运算。
该芯片的微代码通过三个阶段实现 `FPTAN`:
1. **伪除法**:利用 CORDIC 确定必要的旋转角度。
2. **有理近似**:使用帕德近似($3x/(3-x^2)$)高精度处理剩余角度。
3. **伪乘法**:通过位移和加法应用确定的旋转。
通过卸载除法运算并利用专用硬件进行平方和位移,8087 高效地实现了 64 位精度。尽管现代 CPU 现在更倾向于使用多项式近似和向量化库(SIMD)而非 CORDIC,但 8087 依然是计算机史上硬件级巧妙优化的里程碑。
抱歉。
本指南为 Go 并发编程提供了简明扼要的技术回顾,侧重于实际应用而非基础理论。 涵盖的核心主题包括: * **执行与同步:** 利用 **Goroutines** 处理轻量级任务,以及使用 **WaitGroups** 进行同步。 * **通信:** 使用 **Channels**(缓冲通道、定向通道)和 **`select`** 语句处理复杂的数据流与流水线管理。 * **时间与控制:** 通过 **`time.Timer`**、**`time.Ticker`** 和 **`context.Context`** 管理操作,实现稳健的取消与超时控制。 * **安全性:** 使用 **Mutexes**(互斥锁)、**原子操作**和**信号量**防止**数据竞争**(Data Races)和**竞态条件**(Race Conditions)。 * **高级模式:** 利用 **`sync.Pool`** 进行高效内存管理,使用 **`sync.Once`** 实现一次性初始化,以及通过 **`sync.Cond`** 进行信号通知。 * **诊断:** 使用**指标(metrics)**、**`pprof`** 分析器识别瓶颈以及**执行追踪(execution tracing)**来监控运行时健康状况。 * **测试:** 编写可靠的并发测试,包括使用 `synctest` 包进行基于虚拟时钟的确定性测试。 本书专为中级 Go 开发者设计,强调 Go 调度器能够高效管理数千个 Goroutine,同时指出竞态检测器(race detector)对于维护生产级线程安全代码至关重要。
抱歉。
 虽然大英博物馆展出的贝叶挂毯原件门票已售罄,但雷丁博物馆提供了一个绝佳的替代选择。在那里,您可以免费欣赏到一幅全尺寸的手工刺绣复制品,无需排队,也无需支付高昂的门票费用。
这件长70米的杰作由利克刺绣协会于1885年创作,陈列在一个专门的展厅中。由于它避开了11世纪原件所经历的历史磨损,因此色彩依然极其鲜艳。雷丁的这件复制品还因其透明度而独具特色:35名绣工中的每一位都在自己的板块上缝上了名字,博物馆甚至还增加了乔伊·梅森特(Joy Messent)于2019年创作的补白,想象了挂毯遗失的最终场景。
无论您是对诺曼征服、19世纪的针线活,还是仅仅对引人入胜的历史叙事感兴趣,雷丁博物馆都能提供高质量且便捷的参观体验。虽然它可能缺乏布卢姆茨伯里(大英博物馆)那种950年历史的“历史气息”,但这件制作精良的艺术品完美地捕捉了黑斯廷斯战役的宏大故事。博物馆周二至周六开放,免费入场。
抱歉。
近期针对土卫二(Enceladus)的研究,显著增强了人类寻找地外生命的信心。发表在《科学进展》(Science Advances)上的一项研究表明,土卫二的冰火山喷流会自然地将海洋物质分离并富集到独立的冰颗粒中。这一机制简化了对潜在生物特征的探测,因为如果存在微生物,它们会被高度浓缩在特定颗粒中,从而使未来的探测器更容易利用现有技术进行识别。 与此同时,另一项研究成功模拟了土卫二极端、碱性且二氧化碳含量受限的海洋环境。令人惊讶的是,产甲烷古菌——冲绳甲烷嗜热菌(*Methanothermococcus okinawensis*)在这种环境下生长良好,并依靠水岩相互作用产生的氢气维持代谢。这表明土卫二的地球化学环境可能支持类似于地球深海热泉附近的古代代谢系统。 虽然这些发现并不能证实生命的存在,但它们证明了土卫二提供了适宜居住的环境,且其喷流为采样提供了一个独特的现成实验室。这些发现为柏林自由大学新成立的“合作研究中心(CRC 1759)”铺平了道路,该中心将进一步研究使生命能够在整个太阳系中出现并持续存在的基本行星过程。
这段 Hacker News 的讨论探讨了在土星卫星“土卫二”上寻找生命的话题,此前有研究指出其地下海洋可能孕育着生命。
这场讨论反映了科学好奇心与现实考量之间的深刻分歧:
* **科学依据:** 支持者强调,土卫二为天体生物学提供了一个难得且易于获取的“确凿证据”,因为其冰火山喷流能将地下海洋的样本直接喷射到太空中。即便发现简单的极端微生物,也将为理解宇宙中生命的普遍性提供海量数据。
* **哲学争论:** 用户们探讨了这一发现的意义。一些人认为这会是一场“灾难”,因为它暗示“大过滤器”理论预示着未来(的危机);而另一些人则认为这是人类启蒙的必要一步。
* **现实性与成本:** 一小部分声音质疑,当地球面临气候变化和不平等问题等紧迫危机时,投入数十亿美元进行太空任务是否值得。反方则强调,此类投资能推动技术创新、扩展人类知识,并通过研发带来经济价值。
归根结底,这一讨论捕捉到了探索的存在主义价值与地球现实生活压力之间的张力。
该项目提供了一种生成“Token 空间字体”的工具,使特定 AI 模型的每一个 Token 都能以等宽形式显示。通过编译包含分词器规则的自定义字体,用户可以实时直观地查看 AI 模型如何处理文本。 **核心功能与使用:** * **自定义:** 支持多种主流分词器(如 DeepSeek、Llama 3、OpenAI 等)。用户可以编译字体,并在 Discord(通过 Vesktop)或 Slack(通过用户脚本)等平台上使用。 * **可视化:** 该工具支持将 AI 助手的特定消息映射为这些字体,帮助用户通过观察 AI 对语言的切分方式,加深对 AI “思维”过程的理解。 * **技术限制:** 该工具仅作为视觉辅助,而非精确的 Token 计数器。其准确性可能受到浏览器渲染、复杂 Unicode 字符、规范化、换行符和格式设置的影响。尽管已针对空格和 BPE 一致性进行了充分测试,但在某些实验性预设或复杂脚本下,仍可能达到处理极限或产生偏差。 该工具在浏览器本地运行,并为每个支持的分词器提供详细的审计报告,以帮助用户了解其性能及边界情况的限制。
这篇 Hacker News 讨论帖探讨了一个利用等宽 LLM 词元(token)生成字体的项目,并延伸讨论了分词器(tokenizer)的效率以及大语言模型在不同语言中的表现。
参与者指出,目前的分词器主要针对英语进行了深度优化,导致其他语言在词元占用上存在显著冗余;例如,桑塔利语(Santali)或阿姆哈拉语(Amharic)要表达同样的信息,所需的词元数量远高于英语。这种差异引发了关于“分词公平性”的讨论,以及这些低效性是否阻碍了 LLM 在非英语语言中的推理能力。
对话还涉及了一些实际的用户关注点,例如提示词中的拼写错误或语法问题是否会影响词元计数或回答质量。用户思考了 LLM 是否只是“随机鹦鹉”,其表现是否完全取决于特定语言中可用的训练数据量。虽然有人认为 LLM 对英语代码库的依赖限制了其多语言推理能力,但也有人认为,模型内部基于向量的处理方式可能超越了语言障碍,这类似于人类的认知表现会受到执行任务时所用语言的影响。
一条 Twitch 聊天信息如何演变为在主播电脑上的代码执行 How one Twitch chat message became code execution on a streamer’s PC
49 天前
一位安全研究员演示了 OBS Studio 中一个严重的远程代码执行(RCE)漏洞。攻击者只需发送一条恶意 Twitch 聊天信息,即可完全控制直播主的电脑。 该攻击链依赖于以下三个要素: 1. **未过滤的 HTML**:一个存在漏洞的第三方聊天插件将观众的原始消息直接渲染,从而引发了跨站脚本攻击(XSS)。 2. **缺失沙箱**:OBS 在运行其嵌入式 Chromium (CEF) 浏览器时禁用了安全沙箱,移除了 Web 内容与宿主系统之间至关重要的保护层。 3. **引擎过时**:OBS 使用的 Chromium 版本(v127)已过时,其中包含一个已知的、正被广泛利用的 V8 引擎漏洞(CVE-2024-7971)。 通过利用这一 V8 漏洞,攻击者成功在浏览器进程中执行了原生代码。由于 Chromium 沙箱处于禁用状态,这种访问权限立即升级到了宿主操作系统。OBS 团队目前正通过升级 Chromium 引擎并着手重新启用浏览器沙箱来解决此问题。在这些更新全面普及之前,建议用户避免使用会将不可信的观众输入渲染为 HTML 的插件,并将所有浏览器源(Browser Source)内容视为潜在的恶意内容。
最近的一个安全漏洞允许 Twitch 观众通过聊天消息在主播的电脑上触发远程代码执行(RCE)。该漏洞利用了 Twitch 聊天叠加插件中的跨站脚本(XSS)漏洞,该插件会将观众的原始消息渲染为 HTML。
虽然 XSS 本身是一个常见的缺陷,但 OBS Studio 浏览器源的设计加剧了其严重性。Hacker News 上的技术讨论指出,OBS 使用的是过时的 Chromium 嵌入式框架(CEF),更关键的是,它完全禁用了 Chromium 的沙盒安全功能。这种组合使得恶意负载能够逃离浏览器容器,并在主播的机器上执行任意代码。
批评者认为 OBS 的安全状况令人担忧,并指出该项目难以保持其浏览器组件的更新。虽然有人建议 Twitch 应在后端进行清理,但许多专家认为,输出编码必须在显示端进行,因为后端无法预见数据可能被渲染的所有上下文。此次事件重新引发了关于在原生应用程序中嵌入浏览器引擎的风险,以及管理复杂的开源安全依赖项所面临的困难的讨论。