 本摘要探讨了 Nix 如何通过引入“动态派生”(dynamic derivations),从“应用式”(applicative)构建系统向“单子式”(monadic)构建系统转型。
传统上,Nix 是应用式的:整个构建图必须预先已知,这使得工具能够在执行前对构建过程进行推断。然而,动态派生允许在构建过程中定义构建图。虽然 Nix 长期以来通过评估器(evaluator)中的“派生导入”(import-from-derivation, IFD)支持“单子式”行为,但动态派生将此能力转移到了调度程序(scheduler)层面。这使得之前受限于评估器的步骤能够实现并行化、远程构建和缓存。
作者通过一个“掷骰子”实验展示了这一点:构建过程会随机决定是停止还是继续,即在运行时生成依赖图的下一步。除了简单的构建图生成(如 `cargo-dyndrv`)外,该原语还支持复杂的应用场景,例如:
* **状态空间搜索:** 根据发现的情况扩展构建边界。
* **网络爬虫:** 在获取页面时动态发现依赖关系。
* **递归模拟:** 运行进程直到满足特定条件。
虽然这种转变挑战了我们预先审视构建图的能力,但它从根本上拓展了 Nix 的构建边界。
每日HackerNews RSS
抱歉。
JetBrains Air:面向智能代理软件开发的系统化产品 JetBrains Air: A System of Products for Agentic Software Development
53 天前
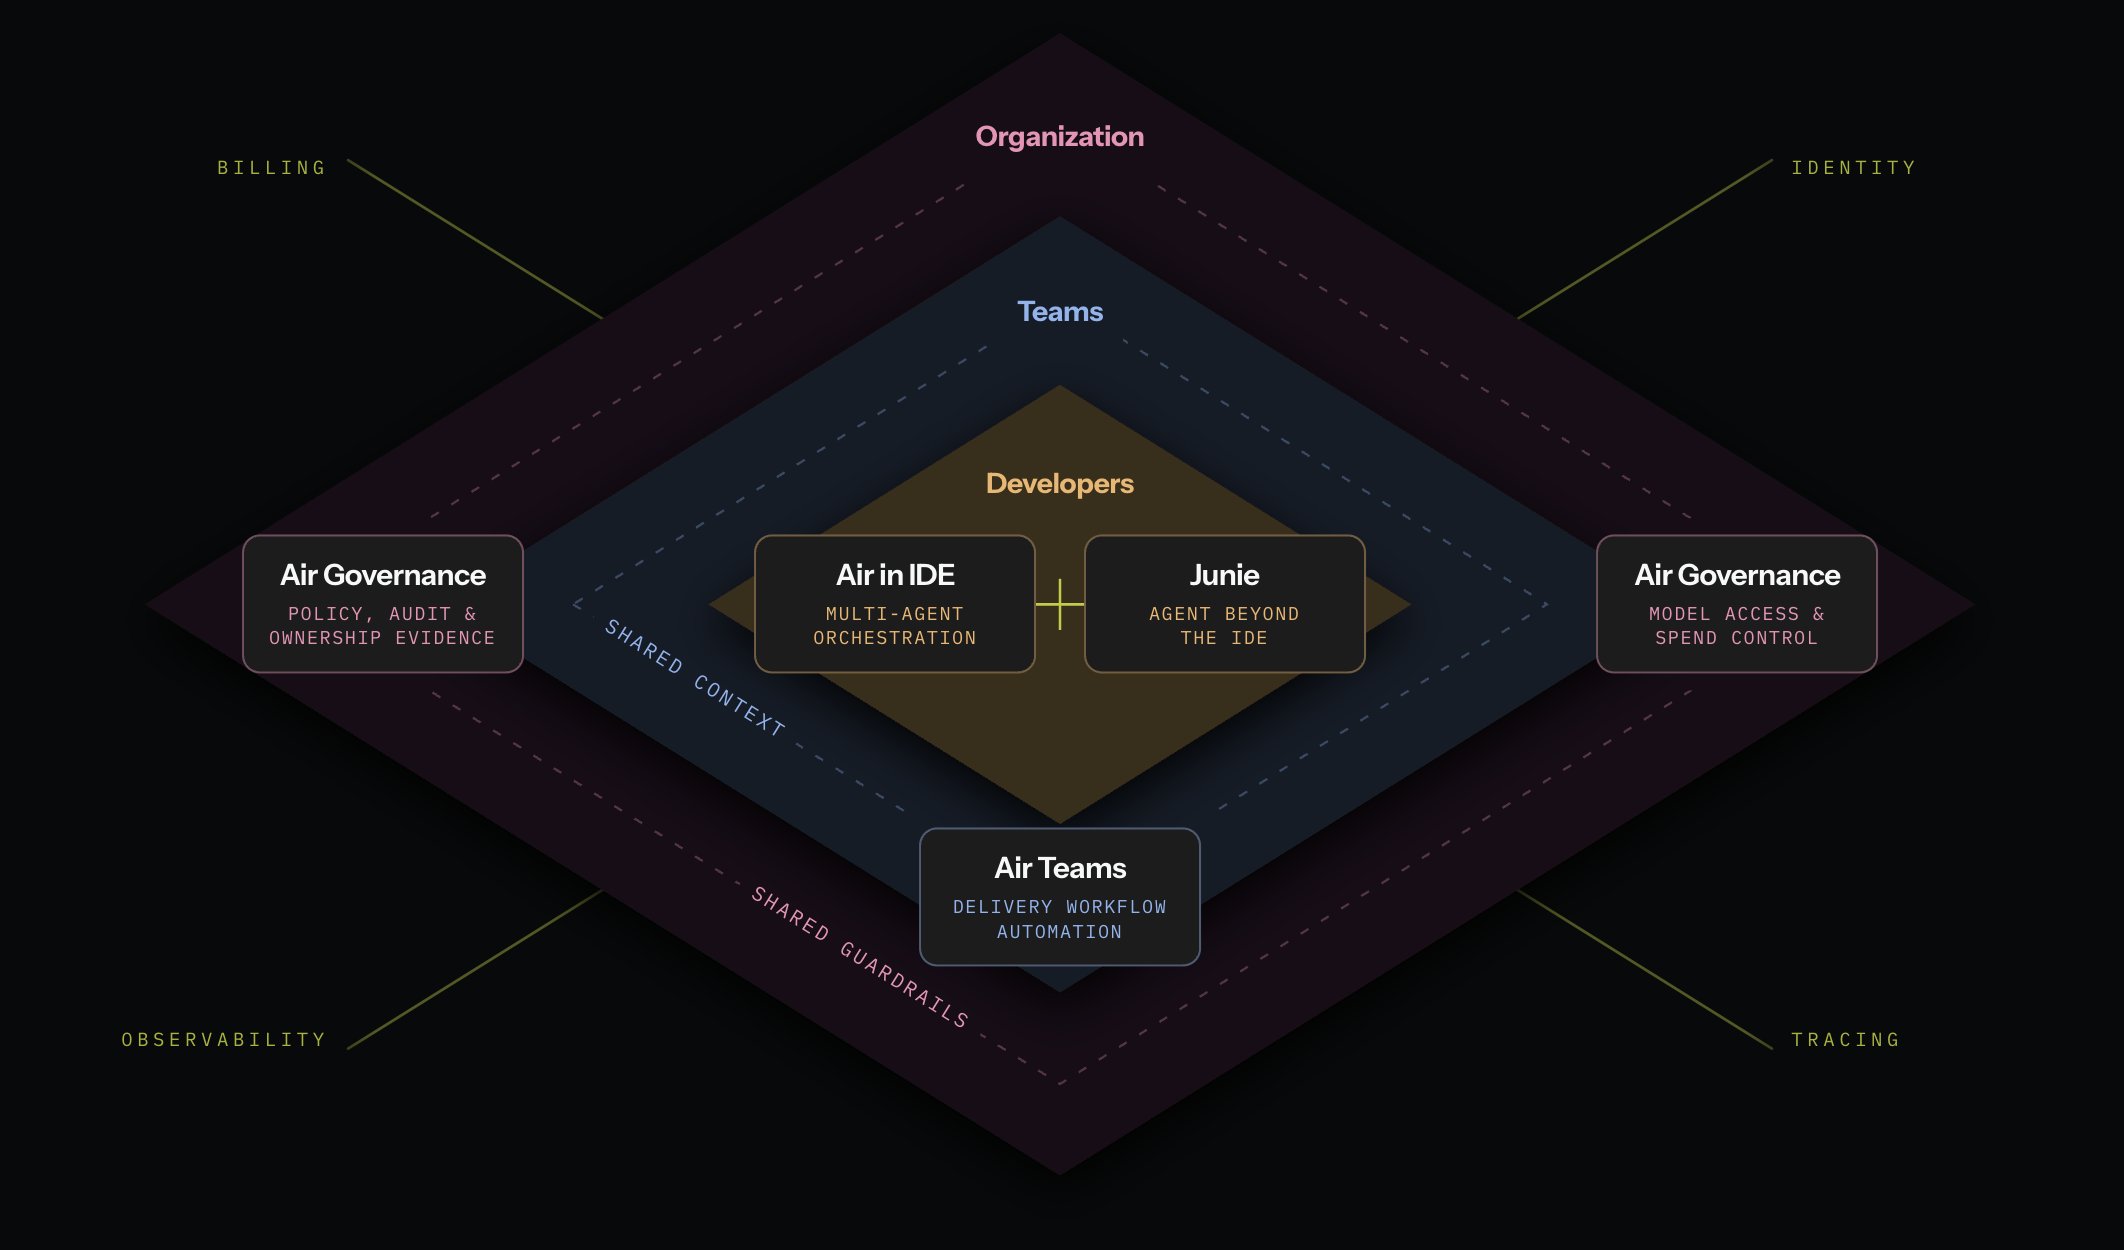 JetBrains 宣布推出 **JetBrains Air**,这是一个全新的开放式生态系统,旨在应对代理式 AI 开发带来的复杂挑战。鉴于企业在管理、审计和控制自主代理方面面临诸多困难,JetBrains 正将其重心从单纯提供个人开发工具(IDE)转向构建一套用于团队协作和组织监管的综合系统。
JetBrains Air 构建于三大核心支柱之上:
* **JetBrains IDE 中的 Air**:强化开发环境,用于指挥代理并验证其代码。
* **Air Teams**:协调开发人员与代理之间的软件交付工作流。
* **Air Governance**:提供集中式可见性、成本管理和安全策略。
该系统的一个关键特性是其**多供应商的开放式方案**。通过代理客户端协议(ACP),JetBrains Air 支持各种模型和代理,确保企业不会被锁定在单一供应商身上。通过将这种灵活性与 JetBrains 深度且确定性的代码智能相结合,该平台旨在解决“验证瓶颈”问题——即 AI 生成的代码易于产出但难以审计的问题。最终,JetBrains Air 致力于帮助企业在不牺牲质量、安全或问责制的前提下,实现 AI 实验的规模化应用。
请启用 JavaScript 和 Cookie 以继续。
每分钟 9 则广告:2026 年世界杯——“美丽足球的代价” 9 Ads per Minute: FIFA Cup 26 – "the price of the beautiful game"
53 天前
来自布里斯托大学和牛津大学的最新研究显示,最近一届国际足联世界杯成为了推广有害产品的巨大平台。研究人员利用英国强大的 Isambard-AI 超级计算机分析了 172.6 小时的比赛直播画面,记录到超过 93,000 次推广不健康食品、酒精、博彩和加密货币的品牌曝光。 其中,不健康食品和饮料的曝光占比超过 70%。研究强调,这种品牌宣传“无处不在且无法避免”,出现在近四分之一的比赛直播时间里。关键在于,国际足联的统一转播信号忽略了可用的虚拟技术,本可以利用该技术替换掉不符合当地法律的广告,但却选择向全球观众——包括那些此类产品受限或非法的国家——展示了不受监管的营销内容。 专家警告称,这种体育赛事中“饱和式”的有害广告投放正在威胁公共健康,尤其是通过使不健康产品和博彩消费“正常化”来影响儿童。研究人员敦促各国政府对体育营销实施更严格的监管,并呼吁国际足联在合作伙伴关系中采纳公共利益标准,确保将儿童健康置于与可预防疾病及社会危害相关的商业推广之上。
 Verda 在获得由 Emergence Capital 领投的 1.89 亿美元 B 轮融资后,估值已达到独角兽级别,其总融资额现已超过 4.5 亿美元。这家总部位于赫尔辛基的公司提供“全栈式”AI 云服务,通过自主设计数据中心、基础设施和软件,为现代代理(agentic)和推理工作负载提供灵活且高性能的计算支持。
截至 2026 年 7 月,Verda 的年化收入运行率达到 1.65 亿美元,服务范围覆盖全球 50 多个国家。该公司的核心竞争力在于其“AI 实验室”,通过开展内部研究以优化 GPU 利用率和软件性能,并将研究成果直接应用于 Aleph Alpha 和 Epsilon Health 等客户的产品开发中。
Verda 目前在全球拥有超过 250 名员工,并计划到 2027 年将其业务规模扩展至 250 兆瓦。未来的投资将重点用于扩大全球数据中心容量、提升推理速度、推出托管式 Kubernetes 服务,以及深化企业级安全与合规能力。通过将硬件设计与以开发者为中心的软件平台相结合,Verda 旨在助力欧洲成为下一代 AI 计算基础设施领域的领导者。
在最初将 GraalVM Native Image 用于移动端部署后,作者将他们的 JavaFX 桌面和命令行(CLI)应用程序迁移到了预先编译(AOT)。他们发现,由于图形界面(GUI)很少达到即时编译(JIT)的触发阈值,因此能从 AOT 中显著受益;迁移到 Native Image 后,启动速度最高提升了 90%,内存占用也大幅降低。 在树莓派(Raspberry Pi)5 上的基准测试表明,经过 AOT 编译的 JavaFX 性能远超标准的 JIT 构建(jlink + CDS),甚至超过了高端台式机的性能表现。 尽管 JavaFX 与 Native Image 高度兼容,但其初始配置过程非常复杂,这导致人们普遍认为 Java 桌面应用与 AOT“不兼容”。作者将这种挫败感归因于那些掩盖了原生层并导致调试困难的“魔法”工具。为了解决这一问题,他们开发了自定义工具,旨在简化最新版 JavaFX 与 Oracle GraalVM 的集成,消除过程中的神秘感,从而让高性能的原生 Java 桌面应用更易于开发。
基于我在电子工程和汇编语言编程方面的背景,我认为英特尔(Intel)和超威(AMD)的顶尖工程团队完全有能力实现高质量的硬件随机数生成(RNG)。 我目前正在等待 AMD 对一个技术问题的反馈。在我的测试中,两款不同的 AMD 处理器在九天内均未产生过零。为了进一步调查,我更新了测试应用程序,增加了基准测试功能,并增加了对不支持 `rdseed` 指令的浏览器的支持。 我的基准测试显示,处理器之间存在显著且无法解释的性能差异;例如,一款 2012 年的酷睿 i5 生成数字的速度比 2017 年的酷睿 i7 快得多,且对时钟频率的依赖程度各不相同。这些发现表明,不同制造商甚至不同处理器版本之间的 RNG 实现存在巨大差异。尽管进行了分析,但我仍无法找到足够的文档来解释这些 RNG 单元的底层架构。我将与 AMD 保持联系,并在有任何进展时进行分享。
Hacker News 的用户正在讨论有关 AMD Zen 2 处理器的一个漏洞:`RDRAND16` 指令无法生成零值。
讨论的核心要点包括:
* **漏洞现状:** 虽然 `RDRAND32` 功能似乎正常,但 Zen 2 芯片上的 `RDRAND16` 在统计学上避免返回零。用户指出,这并非 AMD 首次遇到随机数生成器(RNG)问题;此前的漏洞表现为只返回全 1,这些问题通过微代码更新得到了解决。
* **潜在原因:** 开发人员推测,AMD 可能为了修复早期问题而采取了一种“偷懒”的方案,将零视为错误状态(因为零在其他指令中常被用作熵耗尽的信号),导致硬件直接丢弃该结果并重新生成,而不是将其返回。
* **实际影响:** 专家认为,虽然有偏向的 RNG 存在漏洞,但在 16 位范围内缺失零值不太可能破坏聚合了多个熵源的现代加密系统。不过,用户对硬件层面缺乏一致性和透明度感到不满。
* **安全建议:** 资深贡献者达成共识,即不要依赖单一硬件源。安全的软件应使用加密安全伪随机数生成器(CSPRNG),并混合多种输入(如抖动、系统时间和内核 API)。
**semfont** 是一个轻量级库,旨在通过根据内容的语义自动应用排版样式(包括颜色、字重、斜体和高亮),来提高文本的可读性。 该库使用四个核心指标来评估每个单词: * **效价(Valence):** 情感基调(积极或消极)。 * **显著性(Salience):** 文本中的重要性和频率。 * **惊奇度(Surprise):** 单词的意外程度或对比度。 * **确定性(Certainty):** 作者的自信程度。 semfont 使用两遍扫描算法,首先分析局部词汇模式,然后进行从句级分析,以处理复杂的语言细微差别,例如否定和情感解析(例如,识别出“修复”改善了“崩溃”)。 semfont 针对速度进行了优化,非常适合 AI 聊天界面等需要实时分析的流式应用。它提供灵活的集成方式,从简单的 React 组件到提供原始情感分数的框架无关引擎均可支持。用户还可以通过定义自己的词库来进一步定制该库。通过利用这些语义线索,semfont 能将密集的文本块转换为更易于浏览、更符合人类阅读习惯的信息。 **了解更多信息:** [github.com/RohanAdwankar/semfont](https://github.com/RohanAdwankar/semfont)
Rohan Adwankar 的项目“一种能读懂你所写内容的字体”(A font that reads what you wrote)在 Hacker News 上引发了热议。尽管标题如此,但用户们指出这并非字体,而是一个通过实时语义分析来高亮文本的 JavaScript 库。
该项目旨在通过强调关键词来提高高速文本流的可读性,类似于代码的语法高亮。虽然一些用户称赞该实验是对文本理解的一种创造性探索,并认为它可能对内部笔记或转录内容有用,但许多用户对用户体验提出了批评。批评者认为,高亮显示会产生视觉干扰,阻碍自然的阅读节奏,且无法顾及人类语言的细微差别——因为重点往往是主观的。
技术反馈褒贬不一,有人指出了浏览器兼容性问题,也有人认为标题具有误导性或“标题党”嫌疑。Adwankar 承认了这些反馈,澄清该工具使用的是轻量级启发式算法而非大语言模型,并表示对社区关于语义样式化的看法很感兴趣。总的来说,虽然这一概念被视为一个有趣的实验,但人们对其在主流阅读中的实用性持普遍怀疑态度。
 挪威科技大学(NTNU)研究人员近期对173项关于生成式人工智能在教育领域应用的国际研究进行了综述,结论指出人工智能具有“双重性”。当人工智能被用于挑战和对比不同观点时,它能提升批判性思维与解决问题的能力;但若仅被当作获取现成答案的捷径,它则会阻碍认知发展。
该研究强调,目前对于低龄学生的研究存在显著的知识空白。约80%的现有研究集中在大学生群体,导致我们对人工智能如何影响学龄儿童的认知发展了解甚少。此外,研究人员还指出,现有研究缺乏客观数据,且在地理分布上存在不平衡。
研究结果强调,人工智能并非天生利弊参半,其影响取决于应用方式。研究人员警告称,不加批判的使用可能会导致学习差距扩大。为此,该研究指出教师教育改革迫在眉睫。教师不仅自身需要具备人工智能素养,还必须学会设计让人工智能作为辅助工具而非替代独立思考的教学任务。最终目标是让教育者来塑造人工智能在学校中的角色,而非让技术主导学习过程。
一项最新研究指出了一种日益增长的趋势:年轻用户(9至18岁)正越来越多地放弃谷歌等传统搜索引擎,转而使用人工智能驱动的对话式工具。
Hacker News 上的讨论认为,这一转变是由谷歌搜索所谓的“粪化”(enshittification)所驱动的。用户认为谷歌搜索充斥着搜索引擎优化(SEO)垃圾信息、广告和不相关的结果,导致难以找到直接答案。相比之下,人工智能模型提供了更简洁、直观的界面,模仿了向专家请教的过程。
然而,这种转变引发了争议。批评者警告称,依赖人工智能可能会削弱批判性思维能力,因为用户往往在不核实来源或进行研究“推敲”的情况下就接受了生成的答案。此外,人们还担心其对信息质量的长期影响,因为人工智能生成的内容最终可能会形成错误信息或偏见的反馈循环。虽然支持者认为人工智能是一种更高效的获取知识的方式,但其他人则担心,放弃可溯源的网页会威胁到开放的互联网,并将权力转移到中心化、由广告资助的人工智能平台手中。目前的共识是,尽管人工智能的效用显而易见,但这种行为转变对社会的长期影响尚不得而知。
 作者对苹果激进整合人工智能的做法深感不满,并指出 macOS 更新已系统性地剥夺了用户拒绝这些功能的权利。作者在之前禁用了“Apple Intelligence”和 Siri 后发现,最近的一次升级(macOS 15/27)在未经许可的情况下重新启用了这些工具,隐藏了相关控件,并占用了超过 22GB 的存储空间。
这篇文章严厉批评了“人工智能工业复合体”。作者认为,该行业从根本上无视用户隐私和知情同意。苹果将这些功能隐藏在“家长控制”之下,并强制运行持续的后台进程,被指责为将人工智能的扩张置于用户自主权之上。作者总结道,科技行业拒绝接受用户说“不”,是其普遍道德缺失的体现,并警告说,这种建立在未经同意收集个人数据以及强制使用这些工具基础上的文化,正将社会推向一条危险的轨道。