社会科学目前正受到“量化陷阱”的束缚,行政管理人员依赖于科睿唯安(Clarivate)影响因子或谷歌学术(Google Scholar)等存在缺陷的专有指标来评估学术功绩。这些工具往往会助长“操纵”系统的行为,惩罚跨学科研究,且无法涵盖现代大规模协作的复杂性。 近期涌现出如 Research.com 的“D-index”等利基型营利指标,这证明了学术排名并非客观真理,而是武断构建的产物。对此,作者提出了“k-index”,这是一种基于开源数据库 OpenAlex 构建的、由理论驱动的新型指标。与现有工具不同,k-index 通过平衡个人署名、方法论贡献和近期产出等因素来优先考虑研究多样性,同时对过度依赖大规模合著者名单的行为进行惩罚。 最终,作者认为学术界必须从营利性公司手中夺回评价标准。通过利用透明、非专有的数据,学者们可以摆脱那些榨取数百万美元文章处理费(APC)的剥削性出版模式,转而创建能够奖励真正的智力贡献和学术多样性的评价指标。k-index 代表了一种转变,旨在使我们在科学中真正重视的事物变得可见、可问责,并讽刺性地,变得可量化。
每日HackerNews RSS
近期的一场 Hacker News 讨论对“学术界沦为 d-index 攀比竞赛”进行了批判,讨论由 Kevin Munger 的 Substack 文章引发。Munger 揭露,他在某研究平台上的高排名是特意策划的“存在证明”,旨在演示量化学术指标可以轻易被操纵,从而得出任意结果。通过操纵排名变量,他展示了个人可以通过“数据最大化”(statsmaxx)冲上榜首,以此凸显将此类指标视为客观现实的荒谬性。
评论者们通过指出主流研究数据库中的严重缺陷加强了这一批判。他们指出,这些指数往往产生荒谬的排名,例如将 Donald Knuth 或 Noam Chomsky 等传奇人物的排名置于远低于其真实影响力应有的位置。另一些人则指出,这些指标从根本上不利于人文学科等定性领域,因为它们无法捕捉细微差别或语境。
最终,各方达成的共识是:学术排名往往是任意的“精英代码”,而非衡量能力的可靠指标。该讨论串对各机构和管理者起到了警示作用:排名系统极易被操纵,依赖它们来衡量学术影响力是一种存在缺陷且危险的做法。
预计于 2026 年底发布的 PostgreSQL 19 引入了多项重要的新功能与性能改进。核心亮点包括: * **属性图查询:** 实现了 SQL/PGQ,允许用户通过 `GRAPH_TABLE` 使用模式匹配,在现有表上定义并查询图数据。 * **时态特性:** 新增的 `FOR PORTION OF` 语法简化了对记录中特定时间范围的更新或删除操作。 * **性能与运维:** * **REPACK:** 将 `VACUUM FULL` 和 `CLUSTER` 合并为一个命令,并提供 `CONCURRENTLY` 选项,以避免长时间占用锁。 * **自动清理(Autovacuum):** 现在根据计算得出的分数而非任意顺序对表进行优先级排序。 * **预聚合(Eager Aggregation):** 查询优化器现在可以将部分聚合操作下推至连接(JOIN)之前,以减少数据处理量。 * **优化器建议(Planner Advice):** 新的 `pg_plan_advice` 模块允许用户对查询优化器施加约束,这在长期坚持的“无提示(no hints)”原则上做出了一定折中。 * **可观测性:** `EXPLAIN` 现在提供详细的异步 I/O 指标,并能更清晰地洞察 `Memoize` 节点。 * **易用性:** `COPY` 指令现已支持 JSON 输出、跳过表头以及错误处理选项。 **注意:** 开发者需查阅迁移说明,因为 JIT(即时编译)现已默认关闭,且若干旧有功能(如 RADIUS 身份验证)已被移除。
抱歉。
本网站正在使用安全服务以抵御网络攻击。您刚才的操作触发了安全防御机制。触发此拦截的原因可能有多种,包括提交了特定的词汇或短语、SQL 命令或格式错误的数据。
抱歉。

抱歉。
如果特斯拉的无人驾驶出租车队能盈利,他们是不会卖给你的。 If a Tesla Cybercab fleet were profitable, Tesla wouldn't sell you one
69 天前
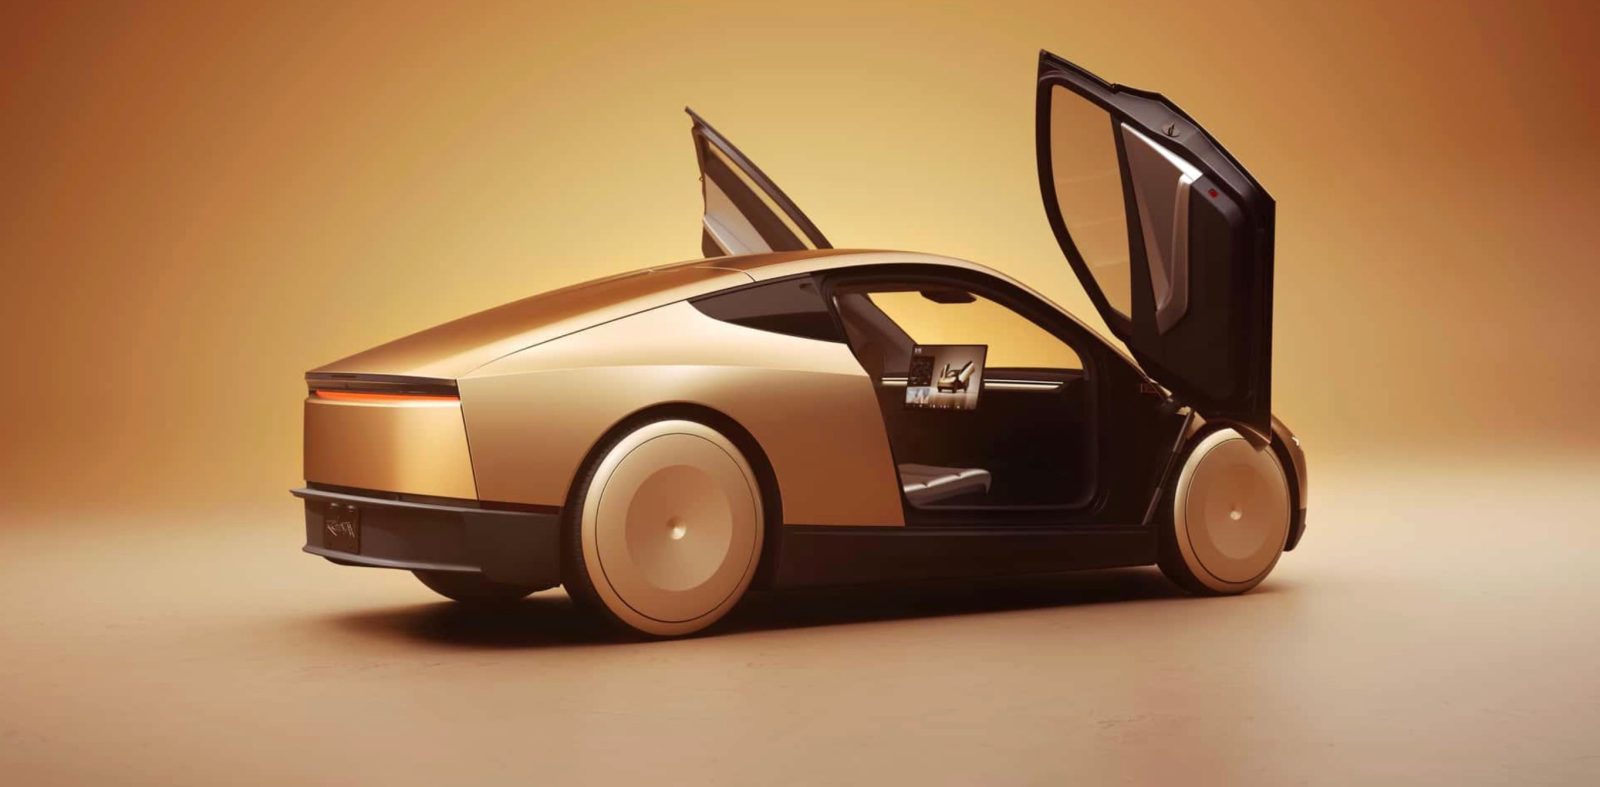 特斯拉再次向企业推销购买并运营“Cybercab”自动驾驶出租车车队的商机,并承诺提供丰厚的被动收入。然而,这与2019年那项从未实现的失败承诺如出一辙,当时导致早期投资者及如MisterGreen等公司蒙受了巨额财务损失,甚至导致后者破产。
问题的核心在于逻辑上的不一致:如果Cybercab真的是能够每年产生巨额利润的“印钞机”,特斯拉大可将整个车队留给自己运营,而非将其出售给外部买家。通过将这些车辆转嫁给第三方,特斯拉成功地将高昂的资本成本和资产折旧风险转移到了买家身上,同时继续掌控软件、网络及服务费用。
在这种安排下,买家承担了整个项目的财务风险,而该项目却完全由特斯拉掌控。特斯拉随时拥有削减价格、优先调度自家车辆或更改收益分配比例的权力。归根结底,Cybercab的推销策略是一种“轻资产”手段,旨在通过转嫁风险来保护特斯拉的利润空间。这再次证明:如果一个商业机会看起来好得不切实际,那它很可能就是个陷阱。
在2003年1月的一封电子邮件中,比尔·盖茨表达了对微软用户体验的强烈不满,并详述了他下载Windows Movie Maker和Plus!软件包失败的经历。他形容微软官网“慢得可怜”且“无法使用”,并指出整个下载过程就像一个无法破解的谜题。盖茨批评了Windows更新过程中复杂的多步骤操作、“添加/删除程序”列表中充斥着测试文件的混乱状况,以及重复且易出错的数据录入表格。他总结道,公司对易用性的漠视简直“令人震惊”。 这封邮件引发了微软高管层内部的紧急应对,以解决这些系统性问题。随后的邮件往来揭示了一家在组织孤岛中挣扎的公司:领导层争论着究竟该由市场部门还是工程部门来“负责”用户体验。内部批评指出,更新流程过于僵化、令人困惑,并且在关键补丁的标注上使用了“令人恐惧”的用词。归根结底,这次交流凸显了公司在优先考虑统一、以用户为中心的下载与安装体验上的普遍缺失;开发者们也承认,当时的流程确实是一团“乱麻”,需要立即但缺乏协调的改进。
在这篇关于其具有深远影响的“数据流模型”(Dataflow Model)论文的回顾中,作者 Akidau 等人反思了流式分析领域的十年历程。虽然该论文准确地识别了向无界、乱序数据转变的趋势,并确立了事件时间和强一致性的重要性,但作者们也承认其中存在重大的概念性错误。 他们认为,自己过分强调了流处理的机制(特别是窗口和触发器),而牺牲了更简单、更稳健的数据库式抽象。作者们现在认识到,“流与表”的二分法是伪命题;流和表仅仅是同一数据的不同访问表现形式。业界向 SQL、增量视图维护和物化视图的转变证明,其目标本应是屏蔽流处理的复杂性,而非将其暴露出来。 最终,作者们得出结论:最成功的流处理范式是那些对用户配置要求最低的范式。他们认为,流处理的未来在于将这些原则整合到标准数据库模型中,不再将流处理视为一种独立的范式,而是将其作为一种保持数据新鲜度的专业化机制。
围绕《重访数据流模型》的讨论揭示了业界资深人士的一个共识:专用的流处理模型在很大程度上未能成为通用分析的主流。尽管流处理曾被视为实现高吞吐量、低延迟系统的理想范式,但专家们如今一致认为,SQL 依然是更优越的抽象。
这种转变源于两个事实:首先,大多数公司实际上并不需要真正的低延迟处理;其次,与批处理系统相比,流处理系统的运维复杂且成本高昂。随着现代数据仓库实现了足够快的数据摄取速度,维持复杂、有状态流架构的理由已不复存在。
行业领袖越来越倾向于将流处理视为数据库底层的实现细节,而非面向终端用户的独立编程模型。未来可能属于“增量维护的物化视图”,即数据流技术的核心优势——如数据完整性标记和避免重复计算——被集成到标准的批处理系统中。虽然流处理对于特定的超大规模问题仍是一种有价值的架构选择,但趋势正在从定制化的流处理语言转向以 SQL 为核心的统一模型,从而将运维的复杂性对用户屏蔽。
必应壁纸展示《哈利·波特》与《神奇动物》系列电影套装广告 Bing Wallpaper showing Ad for Harry Potter and Fantastic beasts box set
69 天前
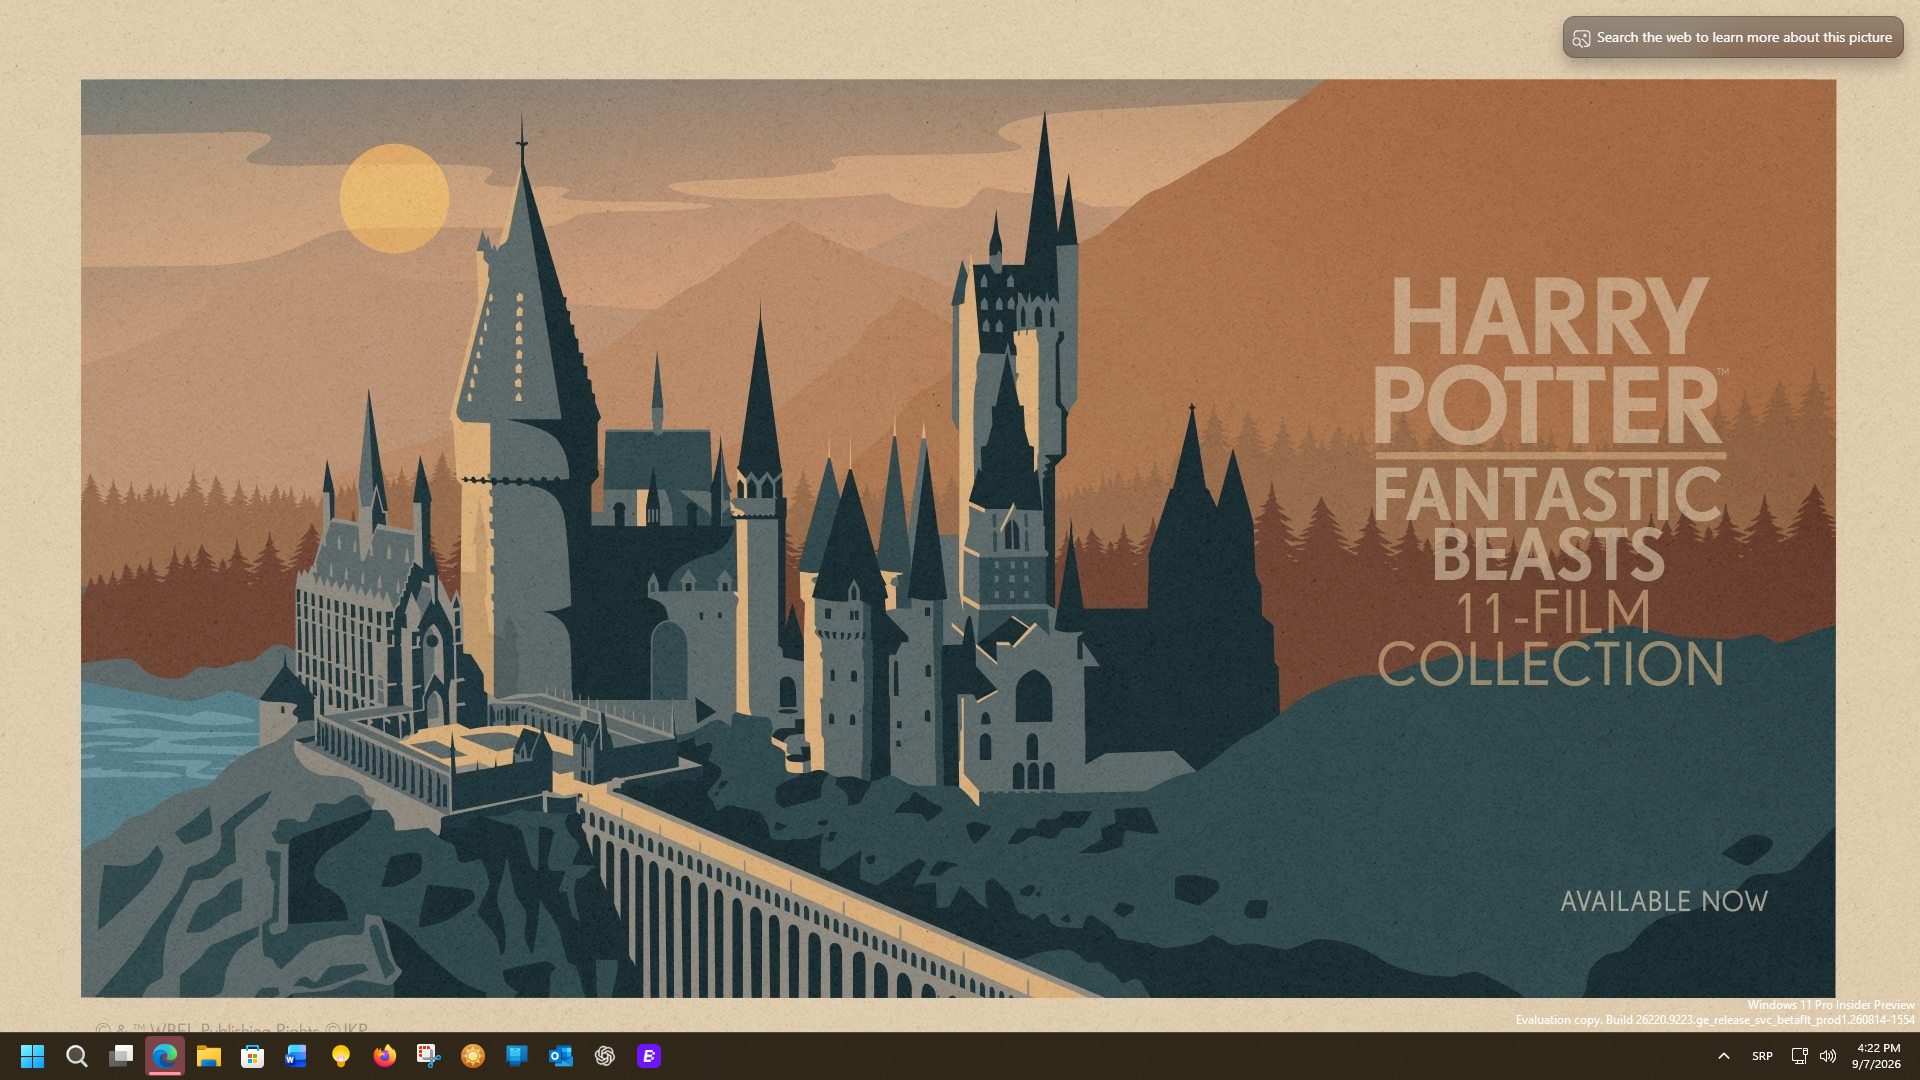 我使用必应壁纸已经很多年了,一直很愉快。但今天我第一次发现壁纸的位置竟然出现了一个广告。这种变着法子收费的行为简直不可理喻。这用户体验太糟糕了,直接占据了整个屏幕,让我一度以为自己安装了什么流氓软件或恶意程序。
抱歉。
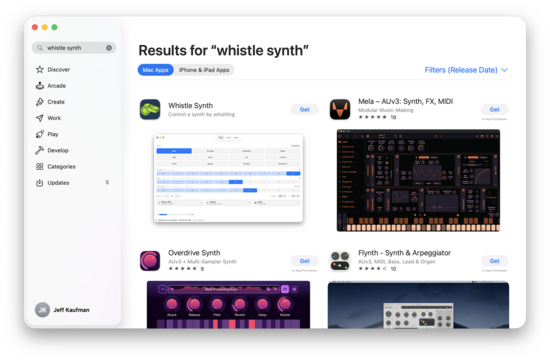 一位开发者发布了一款免费的开源 Mac 应用,允许用户通过吹口哨来控制合成器。通过利用人工智能重构代码库,开发者成功将音频延迟从 80 毫秒降低至仅 5 毫秒,并消除了性能卡顿。
该应用包含多种新音色,包括“无八度”贝斯和拉杆风琴,这些都是通过与 AI 的反复协作开发出来的。开发者还增加了一个五度音程设置,以扩展口哨的音域。虽然开发者在使用 AI 设计长笛和电钢琴等复杂高音音色时遇到了一些挑战,但他们成功利用 AI 完成了 Mac App Store 的提交流程,包括图标设计和行政要求。
该项目证明了 AI 辅助开发的价值,使开发者能够升级并发布一个原本无法实现的热门项目。建议用户配合外接麦克风和有线耳机使用,以获得最佳体验。
 在这篇文章中,作者挑战了将“小”与“简单”混为一谈的普遍观点。他指出,Unix 哲学虽然推崇小巧、模块化的工具,但这些工具往往高度耦合且逻辑复杂。作者以词频计算为例,说明了 Unix 管道(pipelines)由于强制将聚合与排序紧密交织在一起,反而迫使开发者采用了复杂的变通方案。
作者引用 Rich Hickey 对“简单”的定义(即“未交织”或解耦),强调真正的简单在于关注点的分离。尽管小程序在资源受限的环境中很有用,但它们往往缺乏大型、复杂系统所具备的灵活性。相比之下,那些具备良好解耦特性的系统——例如 Clojure 将类型检查与数据表示分离的方法,或是 SQL 的声明式本质——则更为优越。
作者总结道,虽然实现这种程度的解耦通常需要高难度的工程投入,但其回报是更易于维护和扩展的系统。归根结底,开发者应追求构建“简单”而非仅仅是“小”的程序,通过识别并消除不必要的隐性依赖,从而创建稳健、灵活且真正解耦的架构。
抱歉。