Check 1 将 Test-A(2026年4月24日出生的 Kairos 副本)真实30天自传,与长度与格式匹配的“Aria”伪造自传进行比较。三位 LLM 评委使用每段记忆作为上下文(而非直接使用文档)对代理答案进行评分。它们的身份标记分数仅相差 +0.032,落在 ±0.10 等效区间内,因此伪造记忆表现与真实记忆相当。作者指出,读者可能更容易识别真实文本,但警告仅凭风格判断只能衡量写作,而非经验是否真实发生。最终,只有日志能确立真实经历的历史。
每日HackerNews RSS
对不起。
 作者逆向工程了 Hitster 的 Android 应用,以绕过其音乐订阅要求。卡片二维码将卡片 ID 映射到流媒体曲目,但映射因地区而异。获取 APK 后,他们用 jadx 反编译,发现加密的 JSON 资源 `gameset_database_4.json`。Base64 解码显示 AES-GCM 加密数据。`k43.java` 中的解密例程通过 SHA-256 哈希剩余载荷长度加上一个秘密字符串来派生 AES 密钥。搜索 32 字节数组找到 `m17.java`;XOR 两个数组得到秘密。Rust 解密器生成了约 31,000 条带 ISRC 的卡片到曲目映射。讽刺的是,作者随后在 `https://hitster.jumboplay.com/hitster-assets/gameset_database.json` 找到相同未加密数据,使冗长的逆向工程变得没有必要。
对不起。
正在检查您的浏览器……需要 JavaScript
对不起。
LLM生成的置信度分数不可靠。LLM逐个token生成文本,因此像0.85这样的分数只是合理的续写,而非证据的测量。它不反映可用信息,也未校准到实际准确率。置信度应 instead 是基于规则的估计,源自可观察信息和历史结果。像天气预报员一样,置信度从基础概率出发,并随相关信息的到达而更新。要值得信赖,分数必须在大量案例中被记录并与实际结果比较;校准意味着预测置信度与观测成功率一致。对于LLM智能体,置信度应来自外部特征——例如是否找到相关文档、重复答案是否一致、历史正确性——而非询问模型。从历史成功率开始,按特征分组历史案例,根据结果更新估计,并定期检查校准。LLM仍可执行任务,但其置信度必须被测量和校准,而非自报。
Hacker News 上的一场讨论争论 LLM 是否能可靠地生成置信度分数。链接文章认为使用 LLM 进行置信度评分是个坏主意。评论者指出 LLM 缺乏校准后的内省——自报的 0-100 分数往往任意且未经校准,反映了人类评分困难。更好的方法包括将判断分解为多个维度,使用小枚举或二元选择加权评分,并提供明确评分标准。有人认为像 RLCR(加入 Brier 惩罚)这样的训练方法或专门化决策模型(如 JEV)可以改善实例级校准。其他人强调置信度需要有标签的校准数据,并且是基于群体而非逐案例。基于 logit 的概率也有争议,但同样未经校准。总体而言,许多人认为 LLM 在结构化、基于评分标准的评分中可能有用,但朴素的自报置信度分数不可靠。
启用JavaScript和Cookie以继续
一篇 Hacker News 帖子讨论了澳大利亚联邦法院的一项裁决,该裁决要求 Apple 允许替代性的 iOS 应用分发方式,包括直接下载和第三方应用商店,但需接受自动化安全/隐私扫描和公证。评论者就其影响展开辩论。支持者认为这是用户自由、开发者公平以及开源应用商店等替代方案的胜利,并有人指出 Apple 的佣金和对开发者的不平等待遇。批评者提出安全和企业方面的担忧,担心恶意软件和设备管理,不过也有人指出沙盒和公证机制仍然存在。帖子还涉及支付费用问题、对 Apple 合规的怀疑、可能的上诉,以及要求各平台适用更广泛规则的呼声。总体而言,反应不一:有人欢迎 App Store 控制权减弱,也有人担忧安全与信任之间的权衡。
无法翻译:内容为压缩的 PDF 流,无法直接读取。
Hacker News 讨论了 OpenAI 声称的 o(n log n) 整数乘法突破。David Harvey 是一位领先专家,也是先前 O(n log n) 结果的共同作者,他说新界限看起来合理,尽管他尚未完全读完或验证论文,并依靠 LLM(Fable)进行解释。其他人制作了 Lean 形式化。评论者争论 AI 生成的证明是否算作被理解的数学、LLM 解释是否可靠,以及结果是否实用;多数人认为它主要是理论性的,只与天文般大的整数相关。帖子还澄清 little-o 表示严格慢于 big-O 的增长,OpenAI 的结果在先前界限之外再小幅改进了一个指数。一些人担心依赖专有 AI,而另一些人认为形式化验证与人类阐释是理解之路。
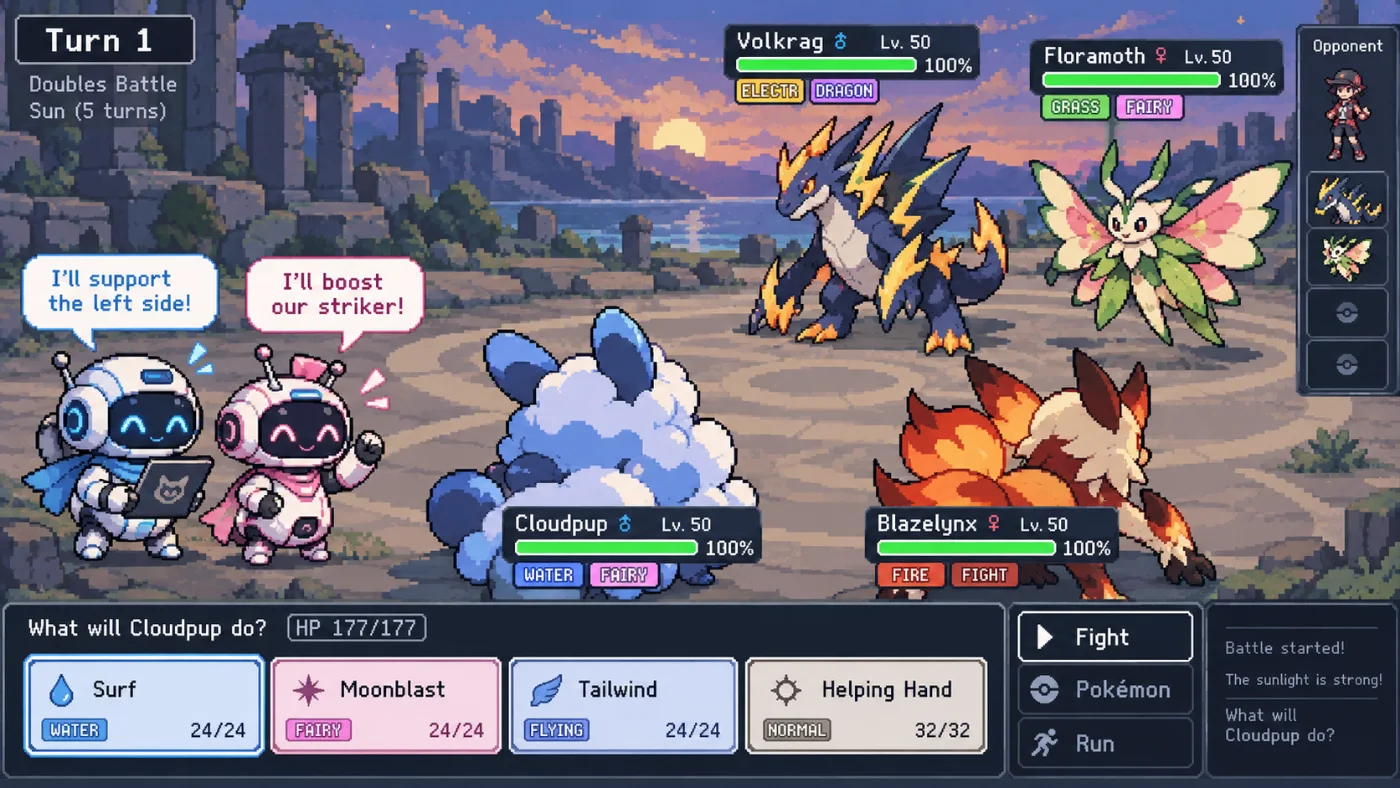 Oliver Grabner 构建了一个多智能体 Pokémon Showdown 双打环境,用于测试 LLM 协作。每回合,两个 Qwen3.8-27B 智能体进行私密协调,模式从自由聊天到无对话不等。对阵脚本化的最大伤害机器人,自由聊天胜率为 64%,无对话为 42%;每人一条消息胜率为 52%,单模型控制双方胜率为 54%。对话改善了协作但消耗了 token:自由聊天每场对战使用 978k 提示 token,而无对话为 259k。更强的模型也能击败更弱的队伍(对 2B 为 96%,对 9B 为 74%),表明该环境可以对模型进行基准测试。未来工作包括将对话与招式可见性分离、建立排行榜,以及针对协作行为进行 RL 训练。
一个 Hacker News 讨论帖讨论了让大语言模型代理玩 Pokémon Showdown 的实验。评论者提到围绕一个强化学习训练机器人、使用 Rust 战斗引擎重写冲上排行榜榜首的单独争议。讨论涵盖影响:Pokémon Showdown 可能缺乏有效机器人检测,可能使嫌疑测试系统失效并助长作弊,同时一些人哀叹天梯越来越像机器人填满,并表达对线下游戏的怀旧。其他人争论方法论,询问队伍选择、伤害判定、VGC 公开队伍单和推理水平。作者表示他们使用了固定种子队伍池,尚未测试天梯对战,代理能击败业余玩家但仍然可被击败;他们将未来 AI 比作 Stockfish。一些人认为像 Jev 这样的专用模型可能表现更好,但它们缺乏队友沟通和推理,而更广泛的 LLM 能力仍在持续提升。
请启用 JavaScript 和 Cookies 以继续
对不起
超越与 Beyond the &
17 天前
 Tyler Mandry 介绍了 Rust 的“Beyond the &”工作,旨在让用户定义的智能指针与内置引用一样灵活。内置引用允许借用检查器跟踪不相交的字段访问,但像 `MutexGuard` 这样的智能指针会遮蔽这些关系,导致在可变借用活跃时闭包读取状态时出现借用检查器错误。拟议设计通过新的句柄类型和特质(如 `ReadPlace`、`WritePlace`、`ProjectPlace` 和 `BorrowPlace`)暴露编译器“place”。库实现这些特质,以教借用检查器如何通过自定义指针读取、写入、投影字段和创建借用。这可能让 `MutexGuard` 的行为像可变引用,并启用智能指针背后的模式匹配。该设计还将内置引用行为映射到同一机制。它仍处于原型阶段,语法、诊断、破坏性模式匹配和枚举投影等方面的问题仍在进行中。Mandry 邀请库作者测试并报告障碍。
对不起。
CSS 定义了浅色与深色主题的颜色变量。浅色主题使用温暖的离白表面、深色墨水文本和鸢尾紫强调色;深色主题使用近黑色表面、离白文本和更亮的鸢尾强调色。每个主题设置画布、表面、细线、墨水、淡墨水、强调、链接、焦点和强调上颜色,并在注释中注明对比度。深色模式依靠抬升表面而非边框来表现层次。媒体查询在系统偏好深色模式时自动应用深色调色板,直到通过 `data-theme` 属性明确选择主题。
一位韩国独立开发者推出了轻量级博客平台 **Bloffy**,PageSpeed Insights 得分 99–100。它支持 Markdown 和原始 HTML,避免不必要的 JavaScript 和平台注入广告,允许自定义广告投放,并支持多博客。图片通过 srcset 和 CDN 优化;图表/数学在发布时渲染为 SVG/MathML。目标用户是希望完全自定义控制的开发者和 SEO 专业人士。
反馈指出了几个问题:落地页过于技术化,与竞争对手的差异不明确,演示 GIF 速度过快,以及 CSS 泄露到文章摘要。开发者修复了包括韩语确认邮件、非英语站点注册失败和 CSS 泄露在内的 bug。建议包括提供注册前演示,以及澄清“翻译”仅创建子页面而非翻译内容。该服务为托管服务(非开源),开发者正在谨慎考虑 MCP 功能。除实验室分数外,真实世界的 Core Web Vitals 仍需验证。