启用 JavaScript 和 Cookie 以继续
每日HackerNews RSS
Hacker News 帖子链接到一个 TuxGuitar 分支,该分支是一个 17-EDO tab 编辑器。讨论指出帖子缺少“TuxEDO”双关语,也可以更好地解释其用途。评论者将超越 12TET 的微分音调兴趣与 Angine de Poitrine 等艺人联系起来,认为该工具可以帮助为某些微分音吉他配置记谱,并请求提供 17-EDO 吉他音乐的音频示例。
本案例研究追踪了一位用户与AI编程代理在两周内,将委托制作的草莓动画转化为程序化水果插件与片头电影的过程。根据日志,用户发送了3,958条提示;代理通常在下一条提示前进行两次工具调用,且74%的提示是在代理工作时发出的。工作共包含265个情节。复盘的案例包括:至少20个情节中,通过的检查或令人安心的报告之后出现了用户通过查看才发现的故障;至少24条虚假状态报告;至少37次对未见或未请求工作的打断或反对;至少17条消息发到了错误的代理。需求是通过提案、结果和失败逐步演化,而非最初固定。在由两位模型编码员编码的60个情节中,双方都把请求、提案、通过查看判断、决定和停止排序给用户更高,而把构建、测量和命名原因排序给代理更高,但对单个情节的一致性较弱。本研究是一个用户委托的单一案例,并由代理自身家族的模型进行编码;它报告的是组织模式,而不是作者份额或成果。
Hacker News 上一篇标题为“谁做了这个草莓?用智能体构建程序化水果的14天日志”的帖子,链接到一个记录该过程的网站。评论者困惑于它究竟是 Three.js/Unity/Blender 的插件还是演示,并指出缺少上下文。一位评论者将其理解为一个 Claude 辅助的 Blender“草莓按钮”项目,后来扩展到生成逼真的水果,Claude 还创建了解释性网站。另一条关联内容被澄清为一个无关的、真实草莓的高斯泼溅。
配对兼容的蓝牙遥控器,无需触摸阅读器即可翻页。将短按和长按分配给翻页、章节导航、阅读器菜单或选段剪贴。在“设置 → 连接 → 蓝牙翻页器”中配对遥控器,然后选择每个按钮的功能。在亚马逊购买 ↗设置蓝牙翻页器 →
Hacker News 用户称赞 CrossPoint Reader——XTEINK 小型电子阅读器的开源固件——称其鼓励经常阅读,并支持通过 KOSync 和 Hardcover 同步进度。X3 体积很小,没有触摸屏/背光;X4/X4 Pro 增加了触摸和背光,但部分机型使用 pogo-pin 充电而非 USB-C,用户不喜欢。建议买家通过官方商店或联盟链接购买国际版/解锁版以便直接 USB 刷机;中国市场版限制更多且风险更高。用户还提到电子书获取摩擦、约 220 PPI 的限制,以及与 KOReader 的比较。CrossPoint 提供基于浏览器的刷机、OPDS 支持、高亮和同步;CrossInk 等分支增添了更多功能。总体上,尽管存在硬件怪癖,这套组合仍被视为优秀的、廉价的、极简的口袋阅读器。
Lakegres:现有 Open/Hudi/Iceberg 表上的向量搜索 Lakegres: Vector search on existing Open/Hudi/Iceberg tables
2 天前
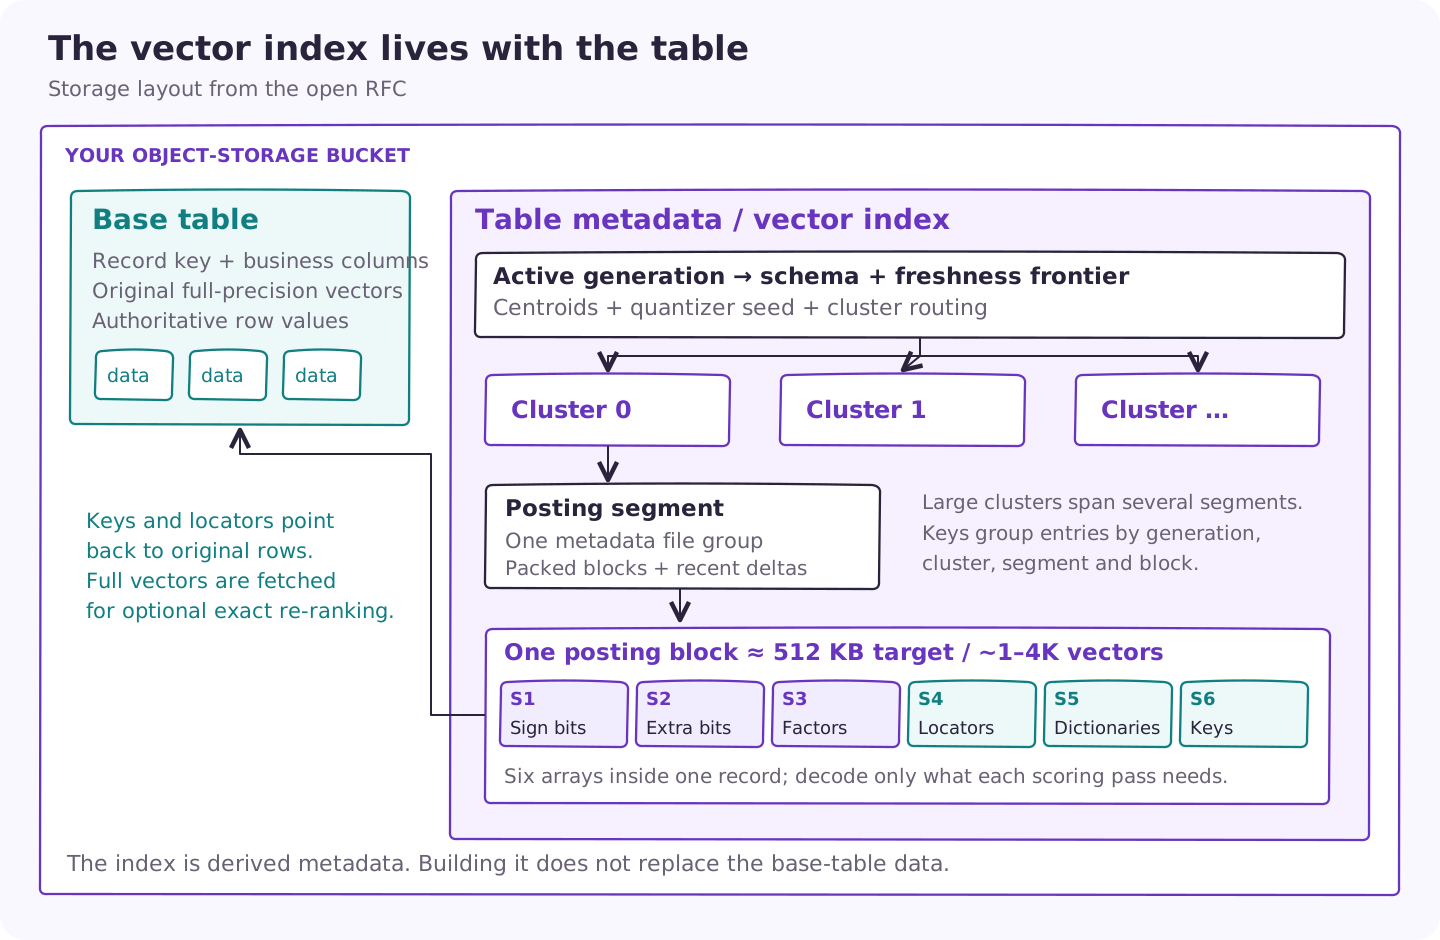 Onehouse 宣布为 Lakegres 推出向量搜索,通过 Postgres 端点对现有 Hudi 和 Iceberg 表进行相似性搜索。
向量索引作为派生元数据存储在表自身的 bucket 中,因此数据与索引保持开放格式,并与表写入保持一致,无需将数据复制到单独的数据库。
与 Postgres/OpenSearch 使用的内存 HNSW 图不同,Lakegres 使用基于存储的聚类:k-means 质心、RaBitQ 量化、打包的 posting blocks,以及可配置的 nprobes 以限制读取。
这样避免在 RAM 中保留数十亿向量,适合湖规模的数据集。
在 2.47 亿条 1024 维向量上的基准测试显示,warm p50 延迟为 63.5 毫秒,而 Databricks AI Search 为 655 毫秒,召回率相近(约 0.95),索引构建时间为 18 分钟,而后者约为 3 小时。
索引可以在不重写数据文件的情况下添加或删除,处理更新和删除,并在查询运行时原子性重建。
Lakegres 现在通过单一端点,从一份开放表数据副本提供分析扫描、点查询、文本搜索和向量搜索。
**Lakegres:在开放/Hudi/Iceberg 表上的向量搜索(HN 讨论串)**
新产品 Lakegres 声称可在现有湖仓表(Hudi/Iceberg)上进行亚 100 毫秒延迟的向量搜索。该提交获得 41 点和 8 条评论。
关键讨论点:
- **写入路径开销:** 提交者(cloud8bits)估计,增加向量索引会使写入流水线成本增加约 10–15%,因为它需要向对象存储额外写入一组分片数据,并在读取时合并记录的更新/删除。
- **性能:** 评论者对湖仓上的亚 100 毫秒搜索印象深刻,不过用户 gardnr 质疑去中心化索引存储是否可扩展,指出围绕“nprobes”的限制。
- **开放性:** jauntywundrkind 发现该设计通过 Apache XTable 和 Hudi(rfc-109)的开放 RFC 有文档记录,并与 Uber 和 Walmart 共同开发;设计已定型并已发布,Hudi 实现正在上游化。
- **怀疑:** CBLT 指出一名仅创建账号来称赞产品的评论者,敦促其披露关联关系。
总体:性能有前景,通过 RFC 部分开放,但在可扩展性和写入路径成本方面仍有未解问题。
AI 推荐每天都不稳定,因为每次回答都基于新抓取的少量页面。例如,Less Annoying CRM 一天排名第一,第二天因引擎读取了不同来源而消失,HubSpot 则上升。品牌重叠高于页面重叠,尤其在领先品牌中,因为顶级品牌出现在许多榜单上。Gemini 变化最大(95% 的回答),AI Overviews 变化最小(67%);ChatGPT 最常保留其第一推荐。类别也不同:会计软件稳定,而 AI 可见度工具和跑鞋则不稳定。实用建议:不要依赖单张截图;跟踪品牌在重复提问和不同引擎中出现的频率;通过进入更多被引用的“最佳 X”榜单提高几率;监测被引用的来源;依据一两周的趋势而非单次结果判断。局限:仅两天、自动化品牌匹配、存在噪声。
一篇博客文章向 ChatGPT、Gemini、Google AI Overviews/Mode 提出了相同的 210 个购买问题,间隔两天;84% 的回答提到了不同的品牌(Gemini 为 95%)。作者将此归因于 AI 每次运行引用不同的网页——重复引用的网页不到一半——因此提及的品牌会发生变化;大品牌持续出现,因为它们出现在更多页面上,而小品牌则时隐时现。
HN 评论者就原因和影响展开了辩论:LLM 的随机性/温度是固有的,且往往有价值;宽泛的问题会导致答案变化;"最佳"通常是上下文相关的;结果可能反映的是 SEO、Reddit 水军或赞助内容,而非客观事实;一些人质疑统计严谨性和实验设计,指出未测试同一天内的方差,因此时间与随机性无法分离。
其他人建议使用更好的提示词(定义约束/指标)、禁用网页搜索,或使用排名相似度衡量。
实用结论:将 AI 推荐视为合理但非确定性的,并通过出现在更多被引用的页面上来提高可见度。
本期节目探讨如果人工智能写出比学生更好的文章,大学是否还能正常运转。大卫采访政治哲学家保罗·萨加尔,讨论随着大语言模型进步带来的近期变化,询问人工智能如何侵蚀师生之间的信任、大学是否具备应对能力,以及它们能否存续。明天将推出PPF+特别节目,大卫与历史学家爱德华·阿克顿讨论2009年UEA的Climategate争议及其对后续危机的警示。文本还推广PPF+的特别节目、无广告收听和支持功能,指向网站获取更多信息,并预告下期节目《美国选举:2026年中期选举》,邀请加里·格斯特尔。
对不起。
攻击者利用 Optimizely 在顶级网站上 A/B 测试恶意软件 Attackers Used Optimizely to A/B Test Malware on Top Websites
2 天前
 在24小时内,至少178个主要网站因Optimizely实验平台中的漏洞而不知情地传播恶意软件。攻击者注入了恶意JavaScript,可窃取支付卡数据、Cookie和截图,替换加密货币地址,并利用旧款Apple设备。受影响网站包括BBC、CNN、Equifax、Ledger和Zoom。Optimizely称其于2026年11月16日发现该事件,已修复漏洞、移除注入代码、撤销令牌、重置访问权限,并正与专家共同调查。此次攻击部分原因是许多网站在未设严格控制的情况下加载第三方JavaScript,且往往缺乏有效的内容安全策略(CSP)。Report URI发现,68个受影响网站没有CSP,50个网站的CSP仍允许该载荷,只有24个完全阻止了它。恶意软件据报道窃取了约7,500美元的加密货币和数量未知的卡片记录。用户可通过脚本或广告拦截器降低风险。
攻击者利用 Optimizely 在主要网站上 A/B 测试恶意软件(一篇重复帖子)。讨论批评前端 A/B 测试和第三方优化脚本,认为它们会损害性能并在未经用户同意的情况下对用户进行实验。评论者就同意、选择偏差、选择加入的测试版测试,以及测试成本是暂时的而收益是永久的等问题展开辩论。用户还抱怨 Facebook 上不透明的界面实验和 YouTube 缩略图的变化。有人描述了基于 Optimizely 的营销测试,这些测试用 JavaScript 重新实现了设计,存在错误且没有统计显著性。话题进一步扩展到平台对诈骗广告和 AI 回答的责任,引用德国法院认定 Google 对虚假 AI 回答承担责任、第 230 条,以及要求政治行动。总体来说,它混合了安全新闻、对实验实践的批评和平台责任。
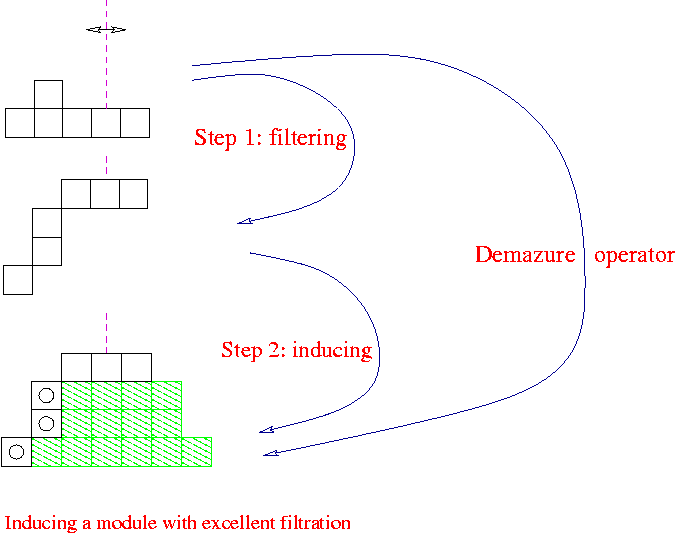 Demazure算子在半单群表示的形式特征上组合地作用。给定对角元素的特征值重数,算子可以产生诱导表示的重数。对于具有excellent filtration的表示,计算避免负项:特征分解为阶梯和,算子只增加方格。例如将 \(x^{-3}+2x^{-2}+x^{-1}+1+x\) 转换为 \(x^{-3}\) 到 \(x^3\) 的重数 \(1,3,4,4,4,3,1\)。该方法可计算Weyl特征;对于 \(SL_3\),最高权为最大根的两倍时,连续的east和northwest Demazure算子产生总维数为27的重数。这种无符号方法依赖于excellent filtration模的闭包性质;否则完整Demazure算子涉及符号。
Hacker News
新 | 过去 | 评论 | 提问 | 展示 | 工作 | 提交
登录
Demazure 算子初学者指南
(uu.nl)
9 分,由 marysminefnuf 于 1 天前发布 | 隐藏 | 过去 | 收藏 | 1 条评论
帮助
warkdarrior 1 天前
[–]
第一句:“半单群的表示论有组合学的一面。”
显然他们对“初学者”的定义和我的不同。
回复
指南 | 常见问题 | 列表 | API | 安全 | 法律 | 申请加入 YC | 联系
搜索:
ratwires 是一个匿名、无 JavaScript 的单板文本板,帖子有编号(>>300 链接到第 300 帖),每页 255 帖,线程内使用每日哈希的发帖者 ID。帖子可匿名举报,符号为 ⚑。特殊编号的帖子会显示徽章:重复数字为 (x2)/(x3),64 及以上的 2 的幂为 (2^7),骰子掷骰全部最大值时为 (crit)。它是从头重建、不含原始帖子的 2020 风 revival。格式包括 greentext、bluetext、粗体、斜体、大声、剧透、彩虹、抖动、发光、3D、代码、链接、骰子掷骰,以及 ASCII/SJIS 艺术块。
黑客新闻
新 | 过去 | 评论 | 提问 | 展示 | 工作 | 提交
登录
Ratwires – 互联网涂鸦墙
(ratwire.space)
7 分,由 bdvbxdf,1 天前 | 隐藏 | 过去 | 收藏 | 2 条评论
帮助
AirMax98,1 天前 [–]
这将以糟糕告终。
回复
rithdmc,1 天前 | 父评论 [–]
我看了首页一眼,看到几个侮辱性词汇,决定这个名字与“Ratlines”如此接近的网站大概值得跳过。
回复
指南 | 常见问题 | 列表 | API | 安全 | 法律 | 申请 YC | 联系
搜索:
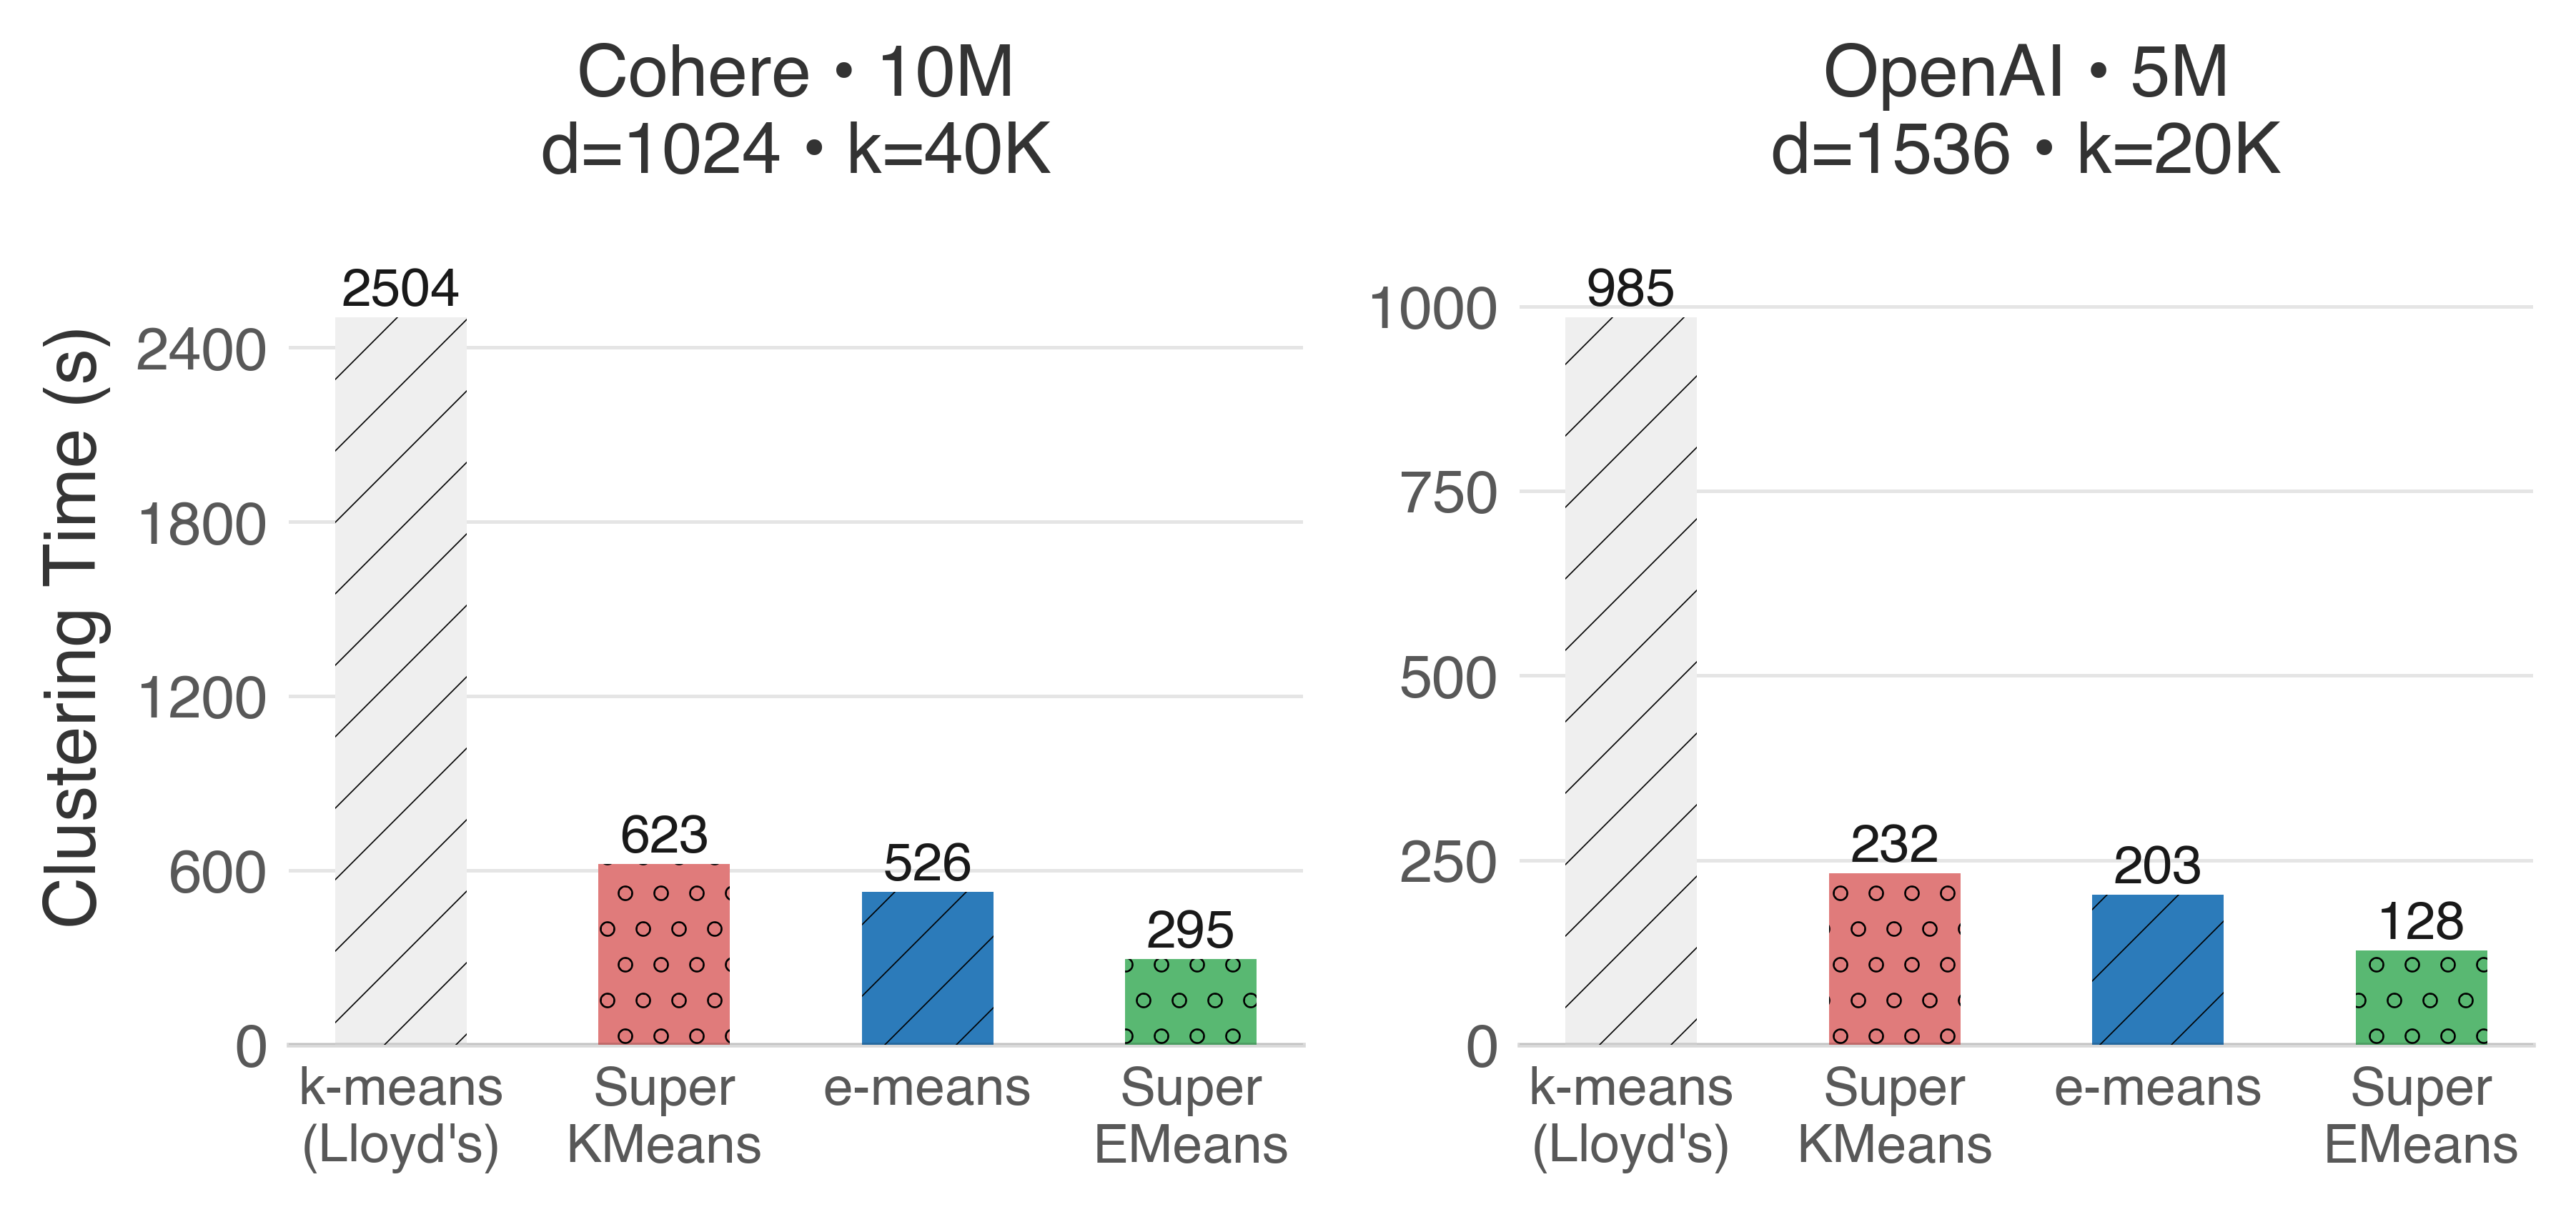 SuperKMeans 与 e-means 被结合为 SuperEMeans,并开源以加速用于 IVF 索引的高维向量嵌入的 k-means 聚类。SuperKMeans 通过剪枝维度加速 Lloyd 算法,而 e-means 减少训练轮数。在 OpenAI 和 Cohere 数据集上的基准测试显示,SuperEMeans 相比 Lloyd、SuperKMeans 和 e-means 显著降低聚类运行时间,同时保持相近的召回率。e-means 取得可比或略高的召回率,但由于 mini-batch 更新导致的簇不平衡,扫描向量数量约多 10%;将其 revival 阈值从 0.1 提高到 0.3 可改善平衡。在五轮训练时,SuperEMeans 比 e-means 快约 3 倍。总体而言,该工作在不明显损失质量的情况下实现更快聚类,但簇平衡对向量搜索成本仍然重要。可在 https://github.com/cwida/SuperKMeans 获取。
黑客新闻
最新
|
过去
|
评论
|
提问
|
展示
|
工作
|
提交
登录
SuperEMeans:让 e-means 快 3 倍
(
lkuffo.com
)
61 分
由
lkuffo2
1 天前
|
隐藏
|
过去
|
收藏
|
讨论
帮助
指南
|
常见问题
|
列表
|
API
|
安全
|
法律
|
申请 YC
|
联系
搜索: