本论文形式化了柏拉图表示假说。它证明,当正样本对是对同一场景的良好视角且不对齐性有界时,基于不同模态训练的联合嵌入预测架构(JEPA)所学到的表示在旋转意义下等价。它认为,下一token预测表现得像使用了坏视角的JEPA,解释了为什么语言模型主要通过规模与视觉对齐。从14.5万条字幕到9.4亿张网络图像的实验揭示了一种对齐缩放定律。良好视角达到相同对齐所需的训练样本比下一token预测少42倍。一个1.09亿参数的文本JEPA比被评估的高达720亿参数的语言模型和CLIP的文本编码器对齐得更好。一个旋转可以将分别训练的编码器组合成图像描述器,在COCO上达到CIDEr 0.838。没有配对数据时,该文本JEPA也优于报告的高达80亿参数语言模型的零样本结果。中心结论:精心选择的正视角,而非单纯规模,是柏拉图表示的关键杠杆。
每日HackerNews RSS
Hacker News 讨论了一篇关于使用 JEPAs 的 Platonic Representation Hypothesis 的 arXiv 论文。该论文认为神经网络表示可以在不同模态之间对齐,一个小文本 JEPA 在基准测试中仅用更少样本就匹配了规模大得多的模型。评论者争论这究竟是深刻发现,还是建模同一现实的预期结果,并将其比作压缩或坐标变换。其他人提出哲学问题,涉及不相容的世界观、客观现实,以及表示是否编码价值观。技术评论指出 JEPAs 前景看好但难以规模化训练,尤其对语言如此;演示输出弱是因为未配对的图像与文本模型通过单一矩阵变换拼接。帖子还包含将 JEPA 与 LLM 结合的猜测,以及某用户投资路演中出现该论文标题的轶事。
大型科技股正在下滑,因为AI基础设施支出已超过利润,但债券市场仍在为这轮热潮提供融资。真正的疑问在于,借贷方还能为大规模前置AI投资提供资金多久,因为利润可能需要数月到数年才能显现。超大规模云服务商占标普500资本支出的很大份额,并预计大量借款,不过高盛估算它们仍有大量投资级债务容量。私募资本也有数万亿美元的未投资现金。风险更高的neocloud面临压力,CoreWeave债券收益率达15%,而超大规模云服务商仍显示强劲的云收入、订单积压、定价权以及不断上升的智能体AI需求。主要风险在于,更高的借贷成本或债券市场的怀疑可能挑战AI经济性,但使用率下降、定价走弱或客户承诺减少等警讯尚未出现。
评论者争论AI繁荣是否可持续。一些人认为超大规模云服务商的收入增长被债务和循环融资推高,而非真实终端需求,并警告若贷款方撤出支持,可能引发类似2008年的崩盘。其他人则提醒过早宣布泡沫破裂还为时过早,指出财报、中期选举、IPO和融资成本可能解释近期疲软。一个反复出现的主题是算力稀缺:GPU和云容量正在售罄,但批评者称许多需求是借来的或囤积的;未使用的GPU可能造成财务压力。类比将AI基础设施比作互联网泡沫破裂后的暗光纤。总体而言,该讨论质疑债券市场资金还能支撑AI支出多久,以及需求能否证明基础设施建设合理。
尽管更换了手机、国家、城市和消息应用,作者的电子邮件地址始终未变。电子邮件依然可靠、可搜索,并且对存储文件、收据和记忆至关重要。它还能让人们与重要的人,包括作者进行有意义的直接沟通。虽然不如新平台花哨,电子邮件仍然是互联网的核心基础设施。
一篇 Hacker News 帖子链接到一篇文章,认为人们应更有效地使用电子邮件。评论者意见不一:一些人觉得建议有用,另一些人批评标题党与类似 AI 的文风。多人质疑电子邮件是否仍处于中心地位,理由包括垃圾邮件、封闭生态、地区差异以及类似 Gmail 账户无故被终止的风险;也有人捍卫电子邮件在官方沟通中的可靠性。用户还争论文章的历史说法及其“人人都把 X 做错了”的语气。总体而言,该帖子对文章持怀疑态度,但对更好的电子邮件习惯有帮助这一点有一定认同。
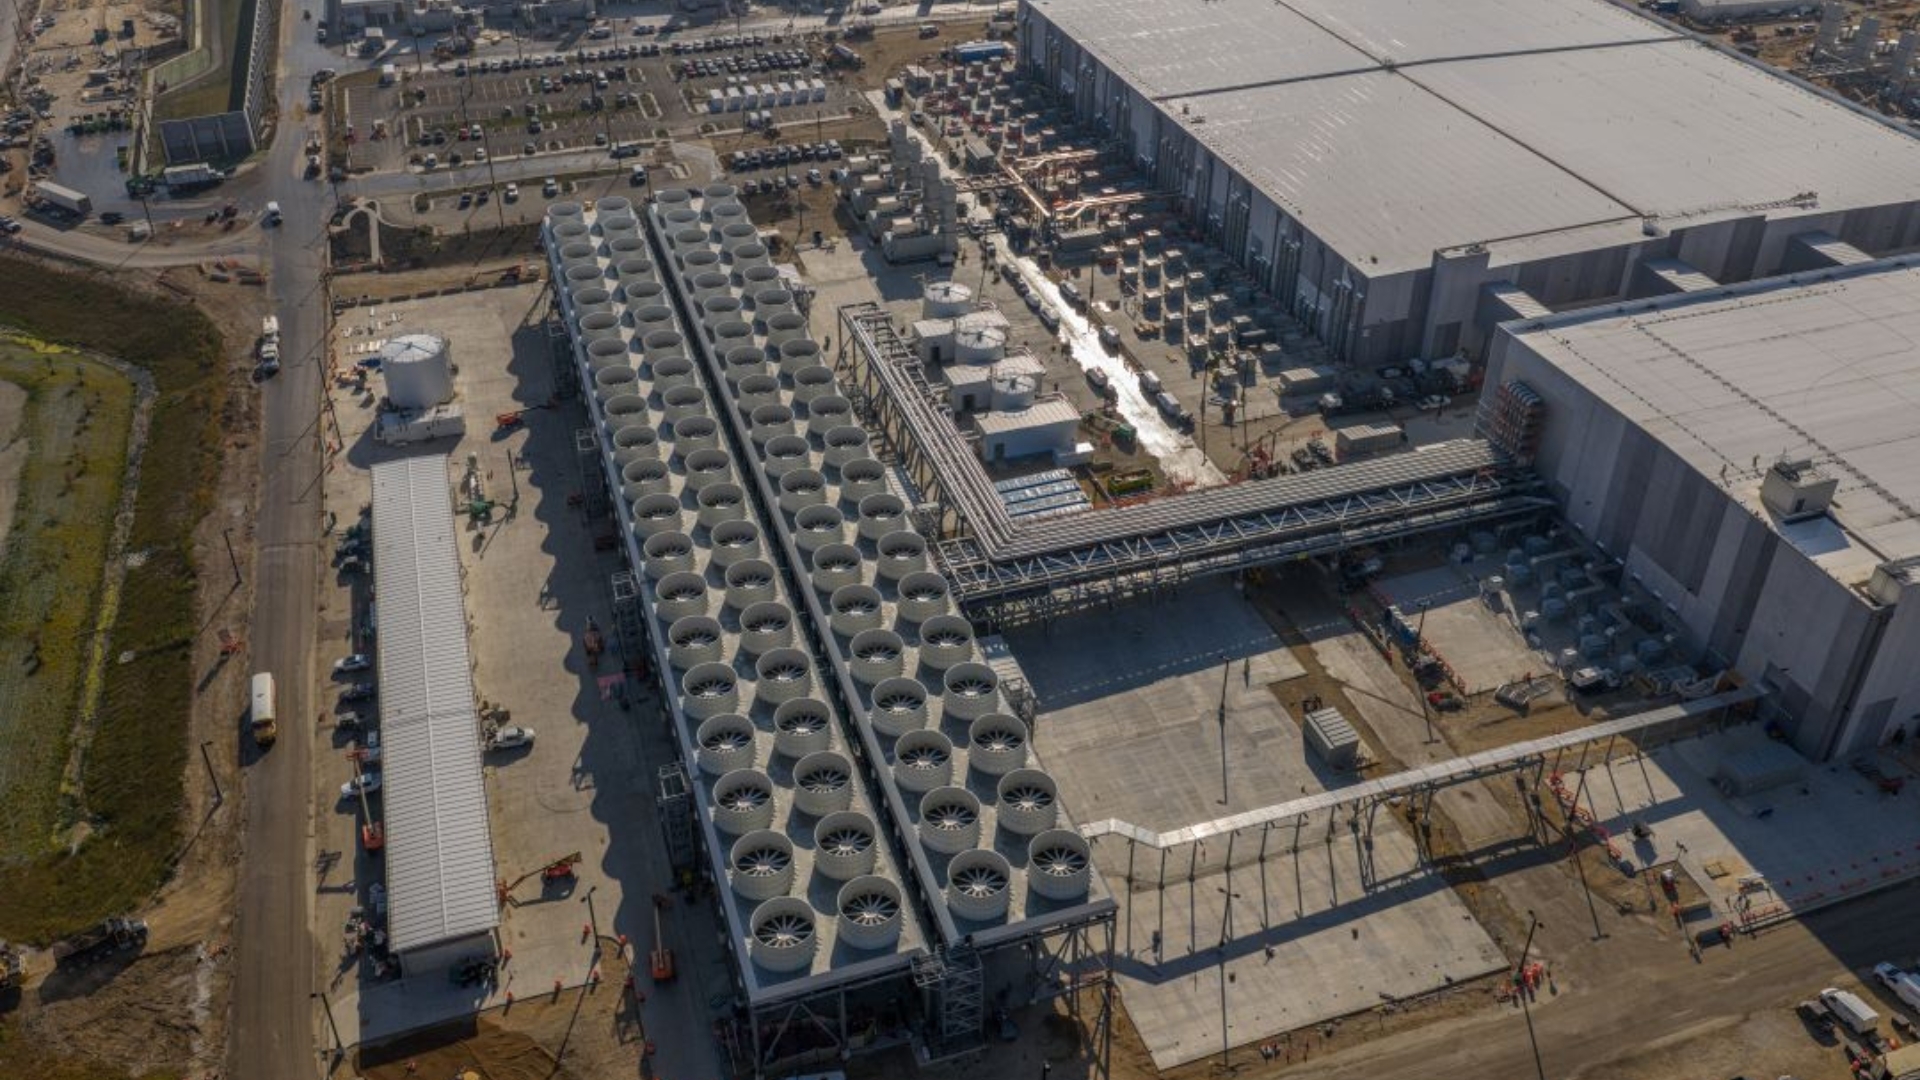 OpenAI 首席执行官山姆·奥尔特曼批评了家用电脑上的本地 AI 推理,称从全球 DRAM 分配的角度来看,这“相当糟糕”。在一次 YouTube 采访中,他辩称,内存有限且仅约 5% 时间使用的个人电脑,与云数据中心中的最大利用率相比效率低下,尤其是在供应受限的情况下。他说许多人的直觉与这一观点相反。
这一立场与 OpenAI 的商业模式一致,该模式依赖闭源的云端模型,尽管公司也提供一些开源选项。如果用户最终在家中运行强大的模型,本地 AI 可能会威胁订阅收入。这些言论也加剧了爱好者对失去硬件和软件所有权、转而租用基于云的代理和计算机的担忧。
奥尔特曼的论点假设数据中心将继续扩张,并认为数据中心 24/7 的内存使用比偶尔在家用于电子表格、游戏和浏览等任务更有价值。采访还涉及 PHP 漏洞、训练中的模型沙箱以及 OpenAI 的数学研究。
Sam Altman 认为个人电脑中的 DRAM 仅部分时间被使用,是一种浪费,应更多分配给数据中心。Hacker News 的讨论大多反对这一观点,称其伪善、自私,是把计算推向集中化、租用化的举措。评论者将此比作囤积住房或器官,批评 AI 数据中心需求推高 RAM 价格,并警告企业对软件、隐私和定价的控制。部分人支持效率论点,指出 PC 往往拥有超出需求的内存,数据中心可更充分地利用,但其他人认为效率并非唯一价值,个人计算同样重要。总体上,该帖持怀疑态度:用户认为这一提案有利于 OpenAI 和超大规模云服务商,减少本地 AI 和消费者选择,并把权力集中在少数公司手中。
好奇心与探索相会之处。数千名 RadiaCode 用户在步行、驾驶和飞行时记录剂量率。Radiaverse 将这些轨迹汇聚成一张共享地图,值得了解的地点由发现它们的人描述。打开地图 如何运作
Hacker News 关于 radiaverse.com 众包“世界辐射地图”的讨论。评论者指出,该地图汇总了手持探测器记录的用户轨迹,导致覆盖不一致、校准问题、比例尺变化,以及可能产生误导性印象。一些热点可能反映探测器行为或局部放射性物体,而非可靠的背景水平。澳大利亚官方高分辨率地球物理调查被作为对比。德国覆盖相对密集,部分归因于 STEM 创作者和核焦虑。用户还抱怨服务条款弹窗和科学价值有限,因为探测器主要测量伽马,数据往往缺乏归一化。具体提到普里皮亚季、福岛、纽约市,以及徒步路径上可能存在的放射性沉积物。总体而言,该地图有趣但不是严谨的辐射调查。
noyb 获胜:法国电子零售商 Fnac Darty 被罚款 700 万欧元 noyb win: French electronics retailer Fnac Darty fined €7M
4 天前
2023年9月,noyb投诉称包括Fnac Darty在内的多个应用在未经用户同意的情况下与第三方共享用户数据。CNIL调查Fnac Darty后发现,其使用了未经同意的追踪器收集浏览历史,用于推荐和算法训练。CNIL对Fnac Darty罚款700万欧元,并威胁若不遵守将处以每天1万欧元的处罚,重申定向广告需要用户同意。
法国零售商Fnac Darty因noyb的投诉被罚款700万欧元。Hacker News评论者就该处罚是否具有意义展开辩论,指出与公司约100亿欧元的收入相比,罚款金额很小,不过其他人指出,不遵守规定可能面临每日1万欧元的罚款,以及对屡犯的更严厉处罚。一些用户还分享了负面消费体验,包括强制推销保险、价格高和商品选择差,而另一些人认为,这笔罚款可能只是换取用户数据访问权的便宜交易。总体而言,讨论围绕罚款的威慑力以及对Fnac Darty的普遍不满展开。
请启用 JavaScript 并禁用广告拦截器
一个 Hacker News 帖子讨论了《纽约时报》关于墨西哥遏制大规模马尾藻泛滥的报道,这种泛滥已使海水变褐并影响海滩。评论者分享本地观察,争论肥料径流和二氧化碳是否驱动泛滥,并争论藻类是否算植物。他们还指出可能的用途和危害:马尾藻可能积累砷,使食物或肥料不安全,尽管有人建议将其用作混凝土粘结剂或生物炭。其他人批评“向 X 宣战”的修辞,并拿政府应对开玩笑。总体而言,该帖子突出了一个几乎没有简单解决方案的环境问题。
启用 JavaScript 和 cookies 以继续
黑客新闻讨论一个小太平洋国家推出全民基本收入。评论者将其与阿拉斯加永久基金比较,并提到美国自由联合契约资金。辩论中心是全民基本收入能否缓冲人工智能导致的失业,尤其在卡车运输业,以及再培训或公共工程是否更好替代。一些人认为就业是获得收入的手段而非目标本身,而另一些人强调支付自动化与闲置工人成本、劳动议价能力以及实际再培训后勤。帖子还涵盖税政策、负所得税与全民基本收入、以及关于搭便车者、通胀和退休者为福利搬家的担忧。总体而言,这是关于全民基本收入可行性、资金来源与自动化背景中作用的广泛辩论。
启用 JavaScript 和 cookies 以继续
一篇关于Visit Norway展示挪威风景路线沿线建筑设计公共厕所的Hacker News帖子。该帖部分因为戏谑唐纳德·特朗普而走红,特朗普在未获得诺贝尔和平奖后称挪威为“粪坑国家”。讨论迅速扩展到美国政治和特朗普行为、全球公共厕所质量比较(称赞日本和斯堪的纳维亚,批评北美)、挪威石油财富与主权财富基金,以及社交媒体在政治极化中的作用。评论者还讨论了“斯堪的纳维亚”与“北欧”的区别、日本垃圾桶稀缺,以及公共基础设施的经济学。尽管有政治题外话,许多人仍欣赏挪威在美观、实用公共设施上的投入,并视其为国家自豪感的来源。
把手机举向峡谷壁、路堑或远处的山脊。通过相机,增强现实将地质图绘制到地面上,标出准星下的地层单位,并标注视野中的山峰和湖泊。打开一个单位的页面,土地保留其颜色,其余变为灰色。
Show HN 发布了 Outcrop,一款 AR 应用,可将地质图叠加在真实景观上,识别岩石、提供描述并重建板块位置。目前可通过 TestFlight/Android 获取,iOS App Store 审批随后进行。评论者称赞其教育价值、板块运动可视化和山峰命名;建议调整 UI(时间滑块方向、经纬线)、推出网页版、支持离线以及添加 ASTER/Landsat 等数据叠加。开发者表示该应用使用 Macrostrat 数据,全球范围内效果质量不一,除部分功能外可离线使用,Flyover Country 中已有 AR 功能。用户指出数据碎片化,并请求诸如在其他地方查找相似岩石类型等功能。部分用户报告设备/追踪问题及营销文案相关担忧。总体而言,这是一款广受好评的地质 AR 工具,有活跃的反馈与后续改进计划。