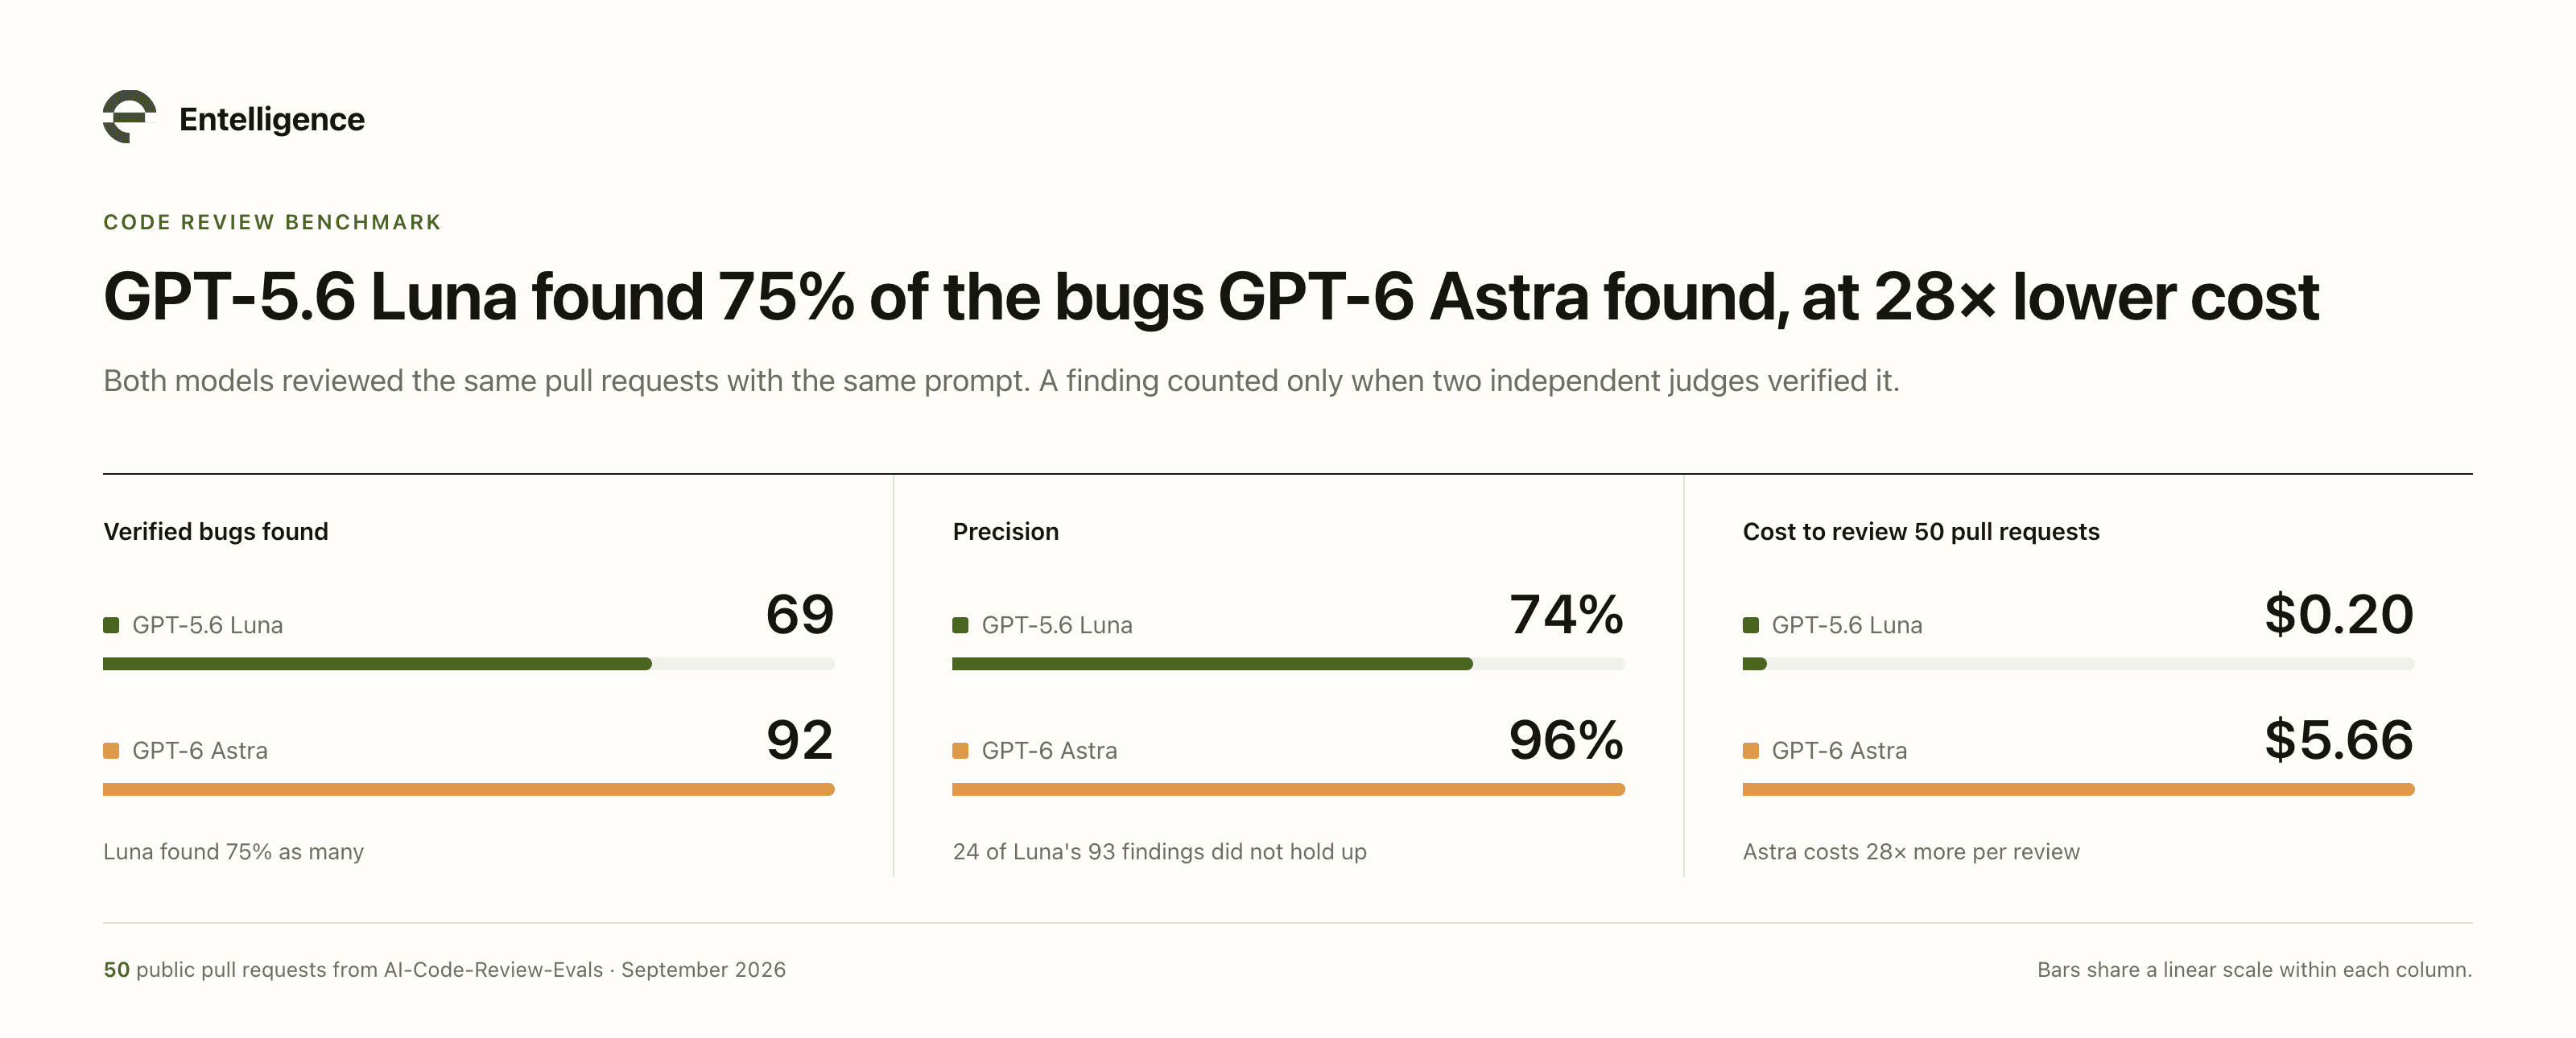
 本分析对比了 **GPT-5.6 Luna** 和 **GPT-6 Astra** 两款 AI 模型在对 50 个公共拉取请求(Pull Request)进行代码审查时的表现与成本效益。
**关键发现:**
* **性能表现:** Luna 发现了 69 个已验证的错误,而 Astra 发现了 92 个。虽然 Luna 在处理一般逻辑和数据错误方面表现良好,但在处理安全性敏感代码时明显吃力(在 24 个安全漏洞中仅发现 9 个,而 Astra 发现了 19 个)。
* **成本效益:** Luna 的成本极低,单次审查费用为 0.0041 美元,而 Astra 为 0.113 美元(相差 28 倍)。从每个已验证错误的成本来看,Astra 的开销是 Luna 的 20 倍。
* **精确度:** Luna 的误报率较高,精确度为 74%,而 Astra 为 96%;这意味着 Luna 的评论中约有四分之一为误报。
**结论:**
Luna 以极低的成本在日常正确性检查中非常有效,但它缺乏处理身份验证和权限密集型代码所需的深度。作者建议采用分层方法:使用低成本模型进行一般性审查,并将强大的模型预留给安全性敏感的逻辑,前提是系统能够区分两者。总体而言,数据表明,仅依赖基于代码差异(diff)的 AI 审查会遗漏完整代码库历史这一重要背景信息。
每日HackerNews RSS
《NüshuRescue:利用人工智能复兴濒危女书语言》(Yang 等人,2025 年)介绍了一个可扩展的、人工智能驱动的框架,旨在协助复兴濒危的低资源语言。研究人员重点关注了女书——一种历史上由中国瑶族妇女使用的独特文字。 为了克服可用数据稀缺的问题,团队开发了“NCGold”,这是首个可公开访问的包含 500 个句子的女书-中文平行语料库。通过利用 GPT-4-Turbo 并仅使用 35 个示例进行上下文学习,NüshuRescue 框架在测试集上达到了 48.69% 的翻译准确率,并生成了包含 98 个新翻译句子的“NCSilver”数据集。作者还实施了额外的 FastText 和 Seq2Seq 模型,以支持持续的语言学研究。 通过最大限度地减少对大量人工干预的需求,NüshuRescue 为研究人员提供了一套通用的自动化工具,用于保护语言遗产。所有代码和数据集均在 GitHub 上公开,以鼓励社区进一步为濒危语言保护做出贡献。
登月舱(LM)通过两扇三角形的斜角窗,为宇航员提供了观测月球表面的战略视野。为确保安全着陆,指令长会使用着陆点指示器(LPD),即刻印在玻璃上的一组网格标记。通过将这些标记与制导计算机提供的数值数据(名词 64)相结合,指令长便能确定登月舱的预计着陆点。如果地形看起来不适合着陆(例如有危险的陨石坑),指令长会使用手控器手动调整飞行轨迹。 在最后下降阶段,宇航员主要依赖视觉线索:即登月舱不断前移的阴影(用以指示与地表的距离)以及 LPD 刻度。在本模拟中,可选的目标环作为教学辅助工具,用以直观显示计算机计算出的着陆点。然而,飞行员必须警惕在 100 英尺高度以下时引擎扬起的月尘。在此阶段,视野可能会变得模糊,需要飞行员将注意力从舷窗转移到驾驶舱仪表上,以完成安全着陆。
正在检查您的浏览器……需要启用 JavaScript
苹果发布了 2027 年度软件更新(包括 iOS 27、iPadOS 27、macOS 27 等),其核心亮点为 **Siri AI**。这一新一代具备情境感知能力的智能助手,支持屏幕内容感知、跨平台历史记录同步,并与相机应用集成以执行实时任务。 主要亮点包括: * **Apple Intelligence:** 各类应用新增人工智能工具,包括增强型照片编辑(空间重构)、用于内容生成的“图像游乐场”(Image Playground),以及更智能的 Safari 标签页管理。 * **儿童安全:** 重新设计的“屏幕使用时间”体验和更完善的家长控制功能,使家长能够以更细致的方式管理应用访问权限、联系人审批及网站浏览。 * **性能与设计:** 整个生态系统的运行速度显著提升,包括更快的应用启动速度、更优的文件传输以及更顺畅的连接体验。UI 界面引入了“液态玻璃”(Liquid Glass)设计优化,带来更具现代感和可定制性的视觉体验。 * **平台特性:** 更新内容涵盖扩展的健康应用功能(如更年期追踪)、Apple TV 的无损音频,以及 Vision Pro 的全新沉浸式环境。 此次更新已于今日面向受支持设备推送。Siri AI 目前支持英语,其他语言支持将于 10 月起陆续推出。部分功能受限于地区法规及硬件要求。
 在这篇博文中,作者表达了对2026年现代电动汽车设计趋势的失望。在尝试寻找一辆满足其需求的汽车后,作者得出结论:整个行业正在将不必要的“小玩意”置于实用且人性化的设计之上。
作者列举了六大主要不满:
* **全景天窗:** 作者认为这种设计既闷热又不舒适,更偏向传统的隔热车顶。
* **过度依赖触摸屏:** 取消了空调、大灯甚至手套箱等常用功能的物理按键,作者认为这既分散注意力又不安全。
* **无钥匙进入:** 基于智能手机和NFC的系统往往不可靠,作者更倾向于使用传统的遥控钥匙。
* **“花哨”的门把手:** 非常规的设计通常难以操作,且在紧急情况下可能存在危险。
* **过度干预的辅助驾驶系统(ADAS):** 虽然安全系统很有帮助,但许多系统的校准很差,导致频繁且恼人的警报。
* **缺乏“单踏板”模式:** 作者认为这是电动汽车至关重要的功能,但令人费解的是,许多车型并不具备该功能。
最终,作者发现几乎每一款现代电动汽车都存在至少一个上述缺陷,这凸显了制造商回归实用、以驾驶员为中心的设计的必要性。
 © Valve Corporation。保留所有权利。所有商标均为其在美国及其他国家的各自所有者财产。隐私政策 | 法律声明 | 无障碍访问 | Steam 订户协议 | 退款 | Cookie
Cloudflare 推出了“自动密钥交换”(Automatic Key Exchange),这是其自动 SSL/TLS 服务的一项扩展功能,旨在消除源服务器连接中的手动配置需求。 此前,Cloudflare 在发起 TLS 1.3 握手时依赖于静态的“猜测”(X25519)。如果源服务器首选其他算法,则会触发“HelloRetryRequest”,从而增加耗时的网络往返。Cloudflare 的新系统会主动探测源服务器以识别其首选的密钥协商算法,使握手能够在首次尝试时即使用最佳算法进行。 此次升级带来两大核心优势: * **降低延迟:** 通过消除不必要的往返,Cloudflare 将 HelloRetryRequests 的比例从 52% 降低至 3.7%,使 p90 握手延迟缩短了 150 毫秒以上。 * **量子安全:** 系统会在支持的情况下优先使用后量子混合算法 `X25519MLKEM768`。这能保护数据免受“先拦截,后解密”攻击,有助于在 2029 年“量子日”截止日期前推动互联网迈向量子安全。 该功能已为所有 Cloudflare 域名默认开启,用户无需进行任何操作。它会持续扫描配置变更,确保连接随着源服务器技术的演进而保持快速与安全。
Cloudflare 近期宣布,其“主动密钥交换”(AKE)计划已将 TLS 握手期间的“HelloRetryRequest”延迟从 52% 降低至 3.7%。通过主动扫描源站以识别其支持的加密算法并存储相关数据,Cloudflare 免除了在初始连接过程中进行二次往返以协商密钥的必要。
Hacker News 上的讨论强调了几个关键点:
* **协议背景:** 评论者指出,此项优化针对的是 TLS 1.3 的一个特定特性。TLS 1.3 旨在最小化往返次数,但当中间设备或不匹配的密钥交换(KEX)预期触发额外延迟时,这一目标有时无法实现。
* **权衡:** 尽管该优化提升了连接速度,但持怀疑态度的人认为,它为每次连接增加了查找延迟,并质疑为何未更早实施,同时指出在庞大的分布式代理网络中管理状态存在难度。
* **行业影响:** 关于 Cloudflare 在基础设施生态系统中的主导地位,引发了更广泛的争论。尽管有些人赞赏其“大规模”的工程能力,但另一些人担心,这种激进的优化和安全中介会增加互联网对单一实体的依赖,使得独立运营商在不“隐藏”于 CDN 后方的情况下,难以维持同等的性能水平。
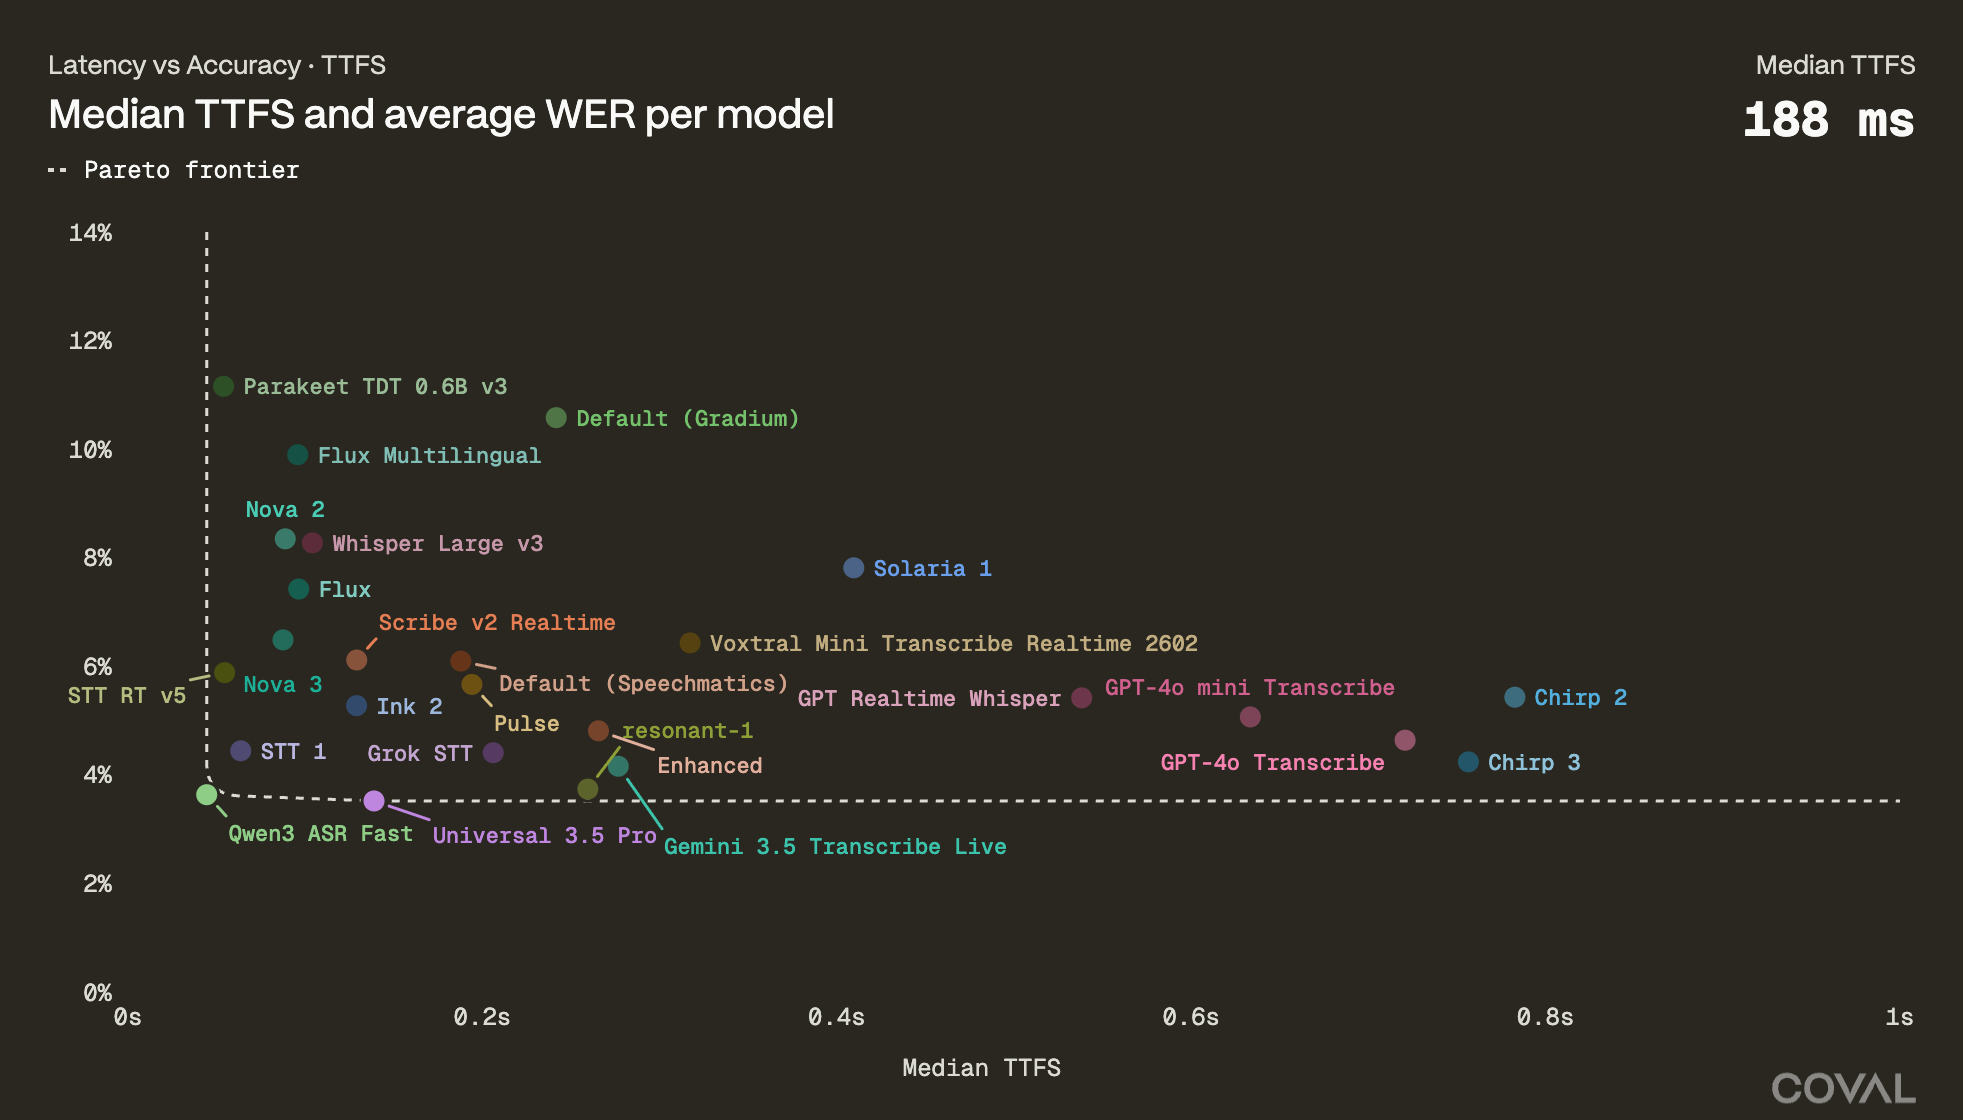 截至2026年9月,Nari Labs 已正式登顶 Coval 语音 AI 基准测试榜单,在语音转文字(STT)和文字转语音(TTS)模型的质量、延迟与成本平衡方面均处于行业领先地位。
在 STT 领域,Nari Labs 的 Qwen3-ASR Fast 模型延迟排名第 1(首字响应时间 44ms),准确率排名第 2(词错误率 3.6%),且价格远低于 AssemblyAI 和 Deepgram 等竞争对手。
在 TTS 领域,Qwen3-TTS Fast 模型延迟排名第 2(首字音频响应时间 63ms),准确率排名第 1(词错误率 3.8%)。尽管性能卓越,它仍是市场上最具成本效益的解决方案,价格比 ElevenLabs 和 Cartesia 等竞品便宜 6.5 倍。
Nari Labs 通过优化“帕累托前沿”(Pareto Frontier),以行业标准价格的一小部分提供卓越性能,持续超越标准模型部署和专用端点。该公司目前正将其公测 API 转为正式商用,并为新用户提供免费试用额度。
Nari Labs 推出了一款针对 Qwen3-TTS 和 Qwen3-ASR 的高性能推理引擎,旨在让开源语音技术比私有替代方案更快、更廉价且更精准。
通过为其多模态模型专门定制推理技术栈,Nari Labs 实现了低于 50 毫秒的延迟。在 Coval 语音 AI 基准测试中,其 Qwen3-TTS 服务在准确率上排名第一,延迟排名第二,在保持最低价格的同时,表现优于 ElevenLabs 和 Cartesia 等主要竞争对手。其 Qwen3-ASR 服务同样实现了顶尖的延迟和准确率表现。
在最近的一次 Hacker News 讨论中,创始人 Toby(toebee)强调了公司致力于通过将推理成本降低至多 10 倍来实现语音技术平民化的决心。尽管其 TTS 引擎是开源的,但 ASR 引擎目前仍处于私有状态,因为团队正在对其优化技术进行文档整理。该团队也正根据社区反馈,积极研究如何提升语音的稳定性和语速。Nari Labs 计划持续扩展这些优化工作,未来目标是开发出类似于 GPT-Live-1、更廉价且开源的实时对话 AI 模型替代方案。