Bloomberg 需要帮助?联系我们 我们检测到您的计算机网络存在异常活动 要继续,请点击下方方框以确认您不是机器人。 为什么会发生这种情况? 请确保您的浏览器支持 JavaScript 和 cookie,并且您没有阻止它们加载。 有关更多信息,您可以查看我们的服务条款和 Cookie 政策。 需要帮助? 如需与本消息相关的咨询,请联系我们的支持团队并提供下方的参考 ID。 阻止参考 ID:fad98465-db8d-11f1-8e4b-a7b2acf3b460 通过 Bloomberg.com 订阅,全球市场重要新闻尽在指尖。 立即订阅
每日HackerNews RSS
苹果CEO敦促软件主管推进更雄心勃勃的AI战略 Apple CEO Presses Software Chief to Pursue More Ambitious AI Strategy
15 小时前
摘要:据报道,苹果 CEO 蒂姆·库克正在向软件主管克雷格·费德里吉施压,要求其采取更雄心勃勃的人工智能战略。这篇彭博社文章引发了 Hacker News 上的广泛讨论,用户压倒性地批评了 Siri 和 Apple Intelligence 的现状。评论者报告了普遍的退步:Siri 在添加物品到特定提醒列表等基本任务上失败,错误识别本地联系人,语音转文本准确率堪忧,且在不同设备上响应不一致。许多人指出 "新版 Siri" 不如其前任,响应更慢,且破坏了以前能正常工作的功能。一些用户为费德里吉的隐私和安全顾虑辩护,而另一些人则归咎于苹果短暂的规划周期和缺乏人工智能专业知识。一个反复出现的主题是,苹果年度软件更新节奏对于快速发展的 AI 领域来说太慢了。用户还讨论了苹果的人工智能商业模式,有些人建议订阅层级或更深入的快捷指令集成可能有所帮助。总体而言,社区认为苹果的人工智能努力落后于竞争对手,许多人呼吁在追求雄心勃勃的新功能之前,先从根本上提高可靠性。
启用 JavaScript 和 cookies 以继续
OpenAI以1.25万亿美元估值筹集了110亿美元,未达到其200亿至300亿美元的融资目标。评论者指出,在AI不确定性下投资者犹豫不决,许多人正在等待Anthropic IPO的表现。一些人认为OpenAI价值低于Anthropic,而另一些人则建议OpenAI的算力领先优势可能让它向竞争对手出租算力。讨论串争辩万亿美元估值反映的是通胀还是真实增长,指出约有14家上市公司市值超过1万亿美元。多名评论者表示,OpenAI的估值在公开市场可能无法维持,且Sam Altman想要比他实际筹到的多得多的资金。有人讽刺地建议直接上市可能将估值推高至4万亿美元。总体而言,情绪持怀疑态度:OpenAI未达目标,面临与Anthropic的比较,可能难以维持其高昂估值。
正在检查浏览器...需要 JavaScript
黑客新闻
新 | 过去 | 评论 | 问 | 展示 | 工作 | 提交
登录
多列不同速度滚动
(master.dev)
8 分 由 ibobev 14 小时前 | 隐藏 | 过去 | 收藏 | 2 条评论
帮助
xeonax 12 小时前 | 下一个 [–]
请不要劫持滚动并改变速度或方向。这会让人迷失方向。
回复
nkrisc 12 小时前 | 上一个 [–]
第一个演示就让我立刻感到运动病。做得很好,网页设计很少能让人感觉如此(字面意义上)恶心。
回复
指南 | 常见问题 | 列表 | API | 安全 | 法律 | 申请 YC | 联系
搜索:
作者认为写作是认知放大器:把思想外化到纸上有助于处理、理解和记忆更多,就像从有限自动机升级到图灵机。思维导图帮助他们处理阅读;写作揭示空白并产生联系。在大语言模型时代,模型了解文献但不了解个人直觉,因此外包思考可能失去创意飞跃;AI生成的备忘录可能模仿思考而未真正思考。因此写作仍是一种日益增长的优势。建议:先通过大量自由写作弄乱,不加评判;然后彻底整理和编辑;保持文笔简单朴素;为自己而非读者写作;并按计划定期写作。写作减缓并聚焦思考,让洞见浮现。
Hacker News 讨论帖将写作视为思考工具,由一篇博文引发。要点:
- 写作不只是总结结果;它是许多人发现实际研究内容的方式。清晰的思路来自反复修改草稿。
- AI 写作有捷径思考的风险。多位评论者认为 AI 生成的文本表明想法未经过深思,关切不会被真正考虑。
- 关于 AI 角色的辩论:有些人仅用其进行编辑反馈(bartread),另一些人因滑坡效应连反馈也避免(4b11b4)。有些人将其用作橡皮鸭。
- 手写(笔/纸、笔记本)被广泛偏好用于自由形式的思考;许多人描述了配色和符号系统。数字工具(Org mode、AI OCR)帮助后续整理。
- 原则延伸到编程和设计:手写代码或手动设计能揭示空白并精炼理解。
- 强调自由写作、编码前先列大纲、以及重读/重新评估笔记(图灵机类比)。
- 注意事项:写作可能变成过度分析;并非所有写作都需要发表;类比有限制。
总体而言,该帖推崇写作——尤其是手写——作为不可替代的思考工具,同时谨慎探索 AI 的辅助作用。
Q Labs认为,AI与人类在样本效率上的差距可以通过在有限数据上训练更大的模型来缩小。他们的数据受限缩放定律从数据集大小、模型大小、轮次和集成规模预测损失,在Chinchilla式定律基础上加入了过拟合项和集成增益。在固定数据集上,计算最优模型大小随计算量持续增长,因此模型应更大并训练更多轮次,权重衰减也应相应缩放。他们还使用通过循环学习率进行的快照集成和深度集成;集成可减少过拟合,并在大预算下成为计算最优。外推到5T tokens时,规定参数量约为1e29 FLOPs下Chinchilla的7,000倍,达到千万亿规模网络。整体方案:先用快照集成扩展模型大小和轮次,再添加深度集成成员,在先前方案损失恶化的场景改善损失。他们总结道,这在有限数据上将网络规模提升四个数量级,但进一步进展仍需要新算法和硬件。
Hacker News 讨论串辩论将人类约 100 万亿突触与 Transformer 参数进行比较是否有效。评论者认为人类具有强归纳偏置和进化“预训练”,大脑处理连续反馈与更丰富信号,且 2 亿 token 估算忽略了庞大但冗余的感官输入。其他人质疑 DNA 能否编码权重,援引本能与物理世界训练;还有人认为 LLM 效率低,未来 AGI 可能不同。讨论还涉及计算扩展、数据冗余与组合类比。
我们的网站安全保护触发了拦截。如果您认为这是误判,请发送邮件至 [email protected]。请在邮件中说明您是如何进入该网页的,并提供页面底部的 Cloudflare Ray ID。如果您想咨询访问我们内容的权限,请发送邮件至 [email protected]。Cloudflare Ray ID:a574f5b0ab7b87cf 返回 The Atlantic
一篇在 Hacker News 讨论帖中引用的《大西洋》文章称,即将于 2026 年出版的儿童书籍严重偏向女性主角;一些家长表示,缺乏男性主角让男孩更难投入阅读。评论者对此有分歧:一些人认为男孩需要更多动作导向或超级英雄故事;另一些人则反对男孩只喜欢男性英雄或动作故事的说法,指出许多以女性为主角的冒险书已存在。还有人将问题归结为出版激励、学校市场销售和代表性争论,部分人认为媒体选择反映的是议程而非受众需求。几位评论者则不以为然,认为孩子可以读更旧的书,父母应鼓励更广泛的阅读。
启用 JavaScript 和 Cookie 才能继续
Hacker News 上的一篇帖子链接到 z1x.us,内容关于将 Android 16 移植到作者盲人母亲的按键手机上。作者开发了一个自定义应用,处理按键、主屏幕和键盘,并表示通话、相机和移动数据等核心功能立即可用,但蓝牙不可用。评论者讨论了无障碍设备常常搭载旧版 Android、成本高、市场小,以及可能的 TalkBack 键盘命令。其他人分享了 Android 按键/键盘手机的历史,建议开源该应用或为 Telegram 做贡献,并争论作者的小写写作风格。总体来说,该帖子突出了实用的无障碍工程以及社区对为盲人和低视力用户提供更好、更现代支持的兴趣。
Hacker News 上一篇关于拒绝在编程中使用 LLM 的帖子引发了尖锐的分歧反应。一些评论者表示,AI 工具让他们能够更快地交付更高质量的产品,即使不手动审查代码,认为模型现在已经“足够好”,竞争压力使得采用成为必要。其他人则坚持审查每一行代码,质疑不审查代码就声称质量的说法,并批评 LLM 输出冗长或具有误导性。
一些评论者将问题框定在身份和工艺上,认为手动编程带来满足感,过度依赖可能会削弱技能或长期生产力。其他人描述了职场采用 AI 的压力,而一些人认为重度使用 AI 只会制造“伪生产力”,熟练的工程师可以超越它。
类比将 LLM 比作电机、计算器或兴奋剂。总体而言,讨论反映了在追求速度的实用主义采用与对代码质量、学习、职业身份和软件工程未来的担忧之间的分歧。
llama-modchip 是一款用于本地运行大型混合专家(MoE)LLM 的 CPU 优化推理工具包。它将 DeepSeek-V4-Flash 从约 76.9 GiB 压缩至约 56.6 GiB,使 284B 模型能在 64 GB 内存与 256K 上下文下运行,预填充约 43 tok/s、解码 9–14.7 tok/s。它还能在 16 核 CPU 上以 25–60+ tok/s 运行 30B Nemotron 模型,支持可选的 Vulkan/ARM 加速。关键技术包括自定义 Fractal-64 量化、分析式 SwiGLU-H2 压缩、L2 MoE 剪枝、缓存感知分块以及 ~96% 接受率的 Stockfish-PVS 投机解码器。它通过快速的 /dev/shm KV 热恢复支持 Claude Code,并支持 Linux、macOS、Windows 与 Apple Silicon。用户可通过一条命令或预编译二进制运行,但其自定义 GGUF 类型需要打补丁的工具链。目标是面向 CPU 的离线、低成本本地 AI。
据报道,Llama-modchip 在无 GPU 的情况下用 64GB RAM 运行 284B 的 DeepSeek 模型,引发争议。支持者强调本地 AI 门槛下降、隐私、无订阅限制,以及与 Claude API/Token 成本相比的盈亏平衡测算。怀疑者认为该方案使用激进的 2-bit 量化,prefill 更慢,质量低于 Opus/Claude 或 Sonnet 等前沿模型;基准测试与真实世界性能不匹配。评论者讨论量化权衡、QAT、硬件配置,以及本地模型对有界任务是否“足够好”。一些人认为 128GB 统一内存系统可用于长时间运行任务;另一些人说 20 tok/s 对交互式工作太慢。总体而言,该讨论线程显示对本地推理优化的热情,但对重度量化本地模型能否替代付费前沿模型订阅存在强烈分歧。
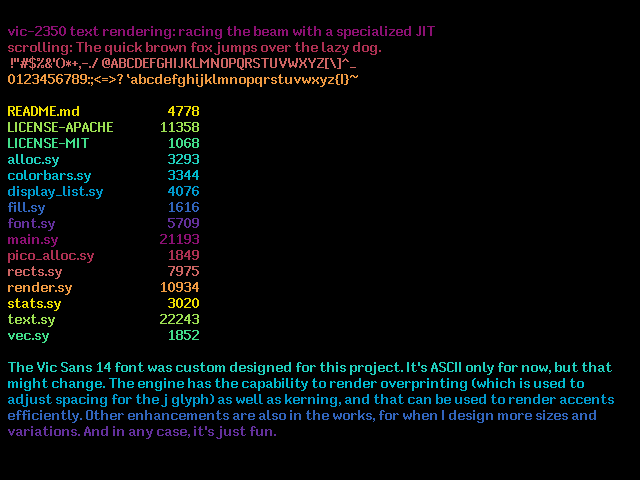 Raph Levien 描述了一种用于 vic-2350 的快速位图文本渲染系统,vic-2350 是基于 RP2350 的一台 80 年代风格计算机。为适应 RP2350 的限制,它采用追光束渲染,按扫描行填充视频,而非使用完整帧缓冲。文本使用带字距调整的可变宽位图字体。显示对象在显示列表中双缓冲;活动对象按扫描行渲染。文本对象存储紧凑字符串与字体数据;其 start 方法分配暂存空间并运行一个 JIT,将每个字符串展开为优化的 ARM 代码,渲染一个 1bpp 中间缓冲区,随后转换为 16 位 RGB。字体紧致打包,字形元数据存放于 32 位字中。JIT 代码生成使用指令重排序以减少周期;渲染每字形约 23 周期加上位图生成,演示中总计约占用一个核心的 2.6%。字距调整使用字形侧边位向量的点积,紧凑存储并在显示列表构建时求值。该方法也可用于帧缓冲。
Hacker News 讨论一种用于微控制器的 JIT 位图文本渲染技术,通过“追着光束渲染”并生成字形绘制代码来避免帧缓冲,以优化有限的 RAM 和存储空间。作者指出内存约束以及速度与空间权衡。评论者提到先行技术,包括 1996 年专利和 DOS 时代的精灵编译,并将其与 Atari 显示列表/光束追逐历史相比较。一些人讨论 RP2350/ESP32 上的帧缓冲等替代方案以及复古 BASIC 需求,还有高度压缩的有损字体实验。其他人提到通过位向量点积实现字距调整以及 LLM 辅助部分。总体来说,这是一个关于低内存嵌入式图形、性能权衡和历史先例的技术帖。