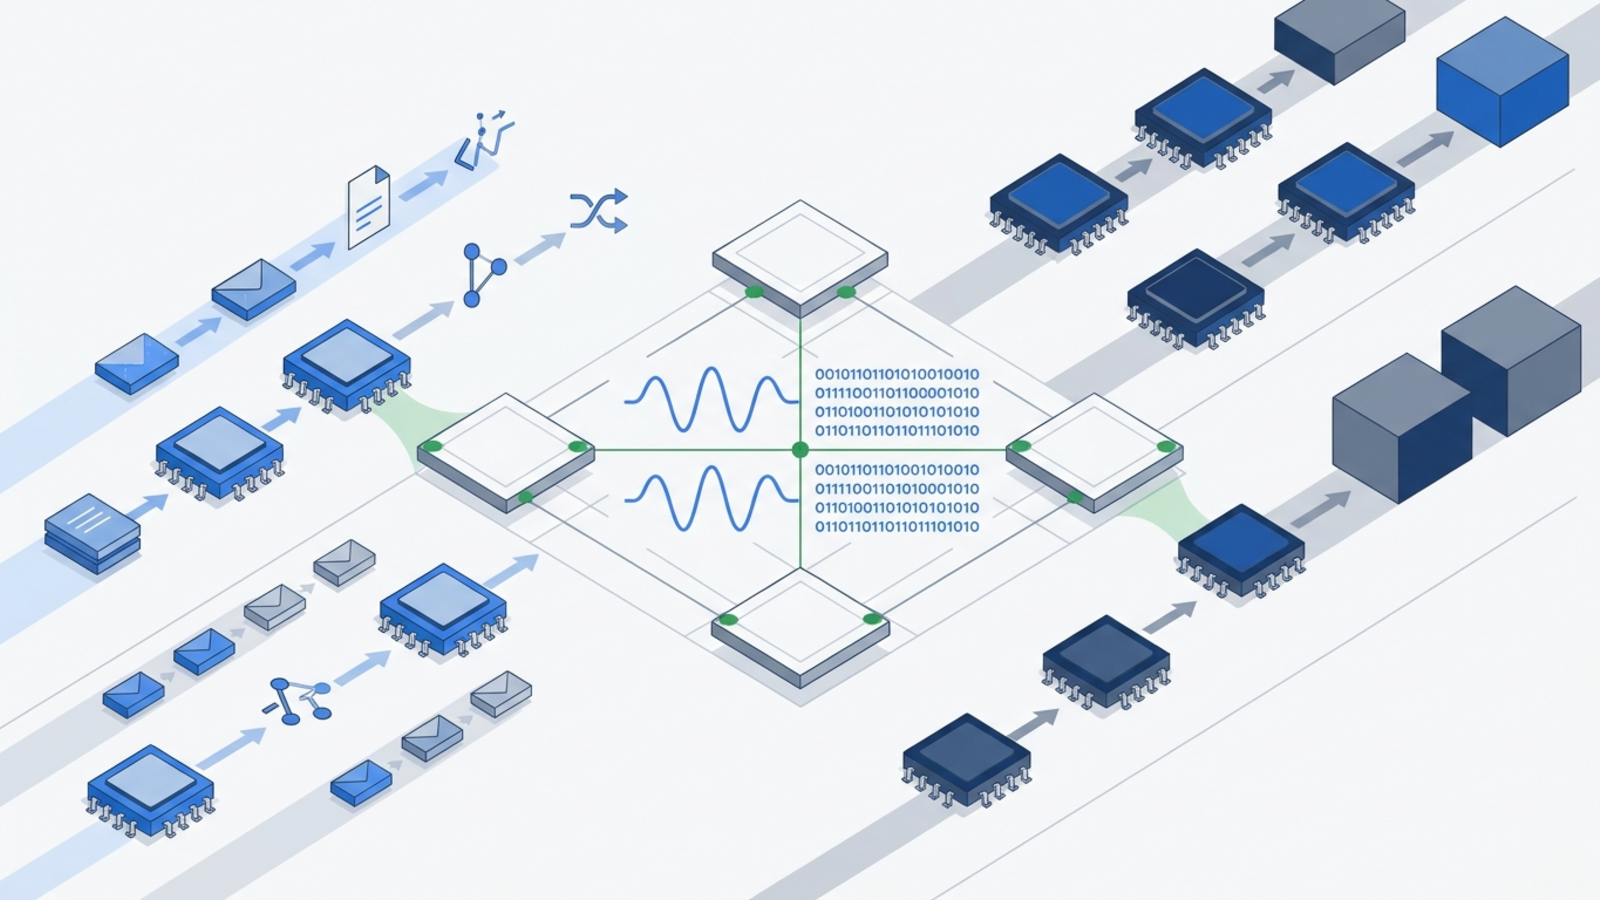
 Zero-TIM(零训练–推理不一致)是面向基于 TPU 的大语言模型强化学习的 Tunix 实现,它使采样器解码、服务端预填充和训练器前向传播在相同权重下产生按位相同的对数概率。这消除了由不同归约顺序、中间精度和执行路径造成的隐藏数值离策略差距。该方法采用四部分配方:具有固定累加顺序和 float32 部分和的批不变 Pallas 内核;用于跨分片归约的显式源秩排序;共享的对数概率评分路径和保留的 token ID;以及复用服务内核进行前向评估同时对匹配副本求导的自定义 VJP。长轨迹使用分页 KV 缓存状态分块。在 64 颗 TPU v5p 芯片上验证,该方法在 FrozenLake 上 200 步内实现了采样器–训练器对数概率平均绝对差为零,并且比标准和 TIS 基线具有更高的求解率。模块化的 JAX/XLA/Pallas 模式旨在更广泛地支持多主机 TPU 强化学习采用。
每日HackerNews RSS
一个 Hacker News 帖子链接到一篇 Google 博客文章,内容是关于通过消除训练-推理不匹配,在 TPU 上解锁稳定的 on-policy 强化学习。该帖有 10 分和一条评论。评论者提出另一种方案:让模型从略微 off-policy 的 rollout 中学习,并将人类 on-policy 学习与运动员观看自己近期尝试的学习作比较。他们指出,ML 可能避免使基于视频的学习对人类效果较差的感官限制。
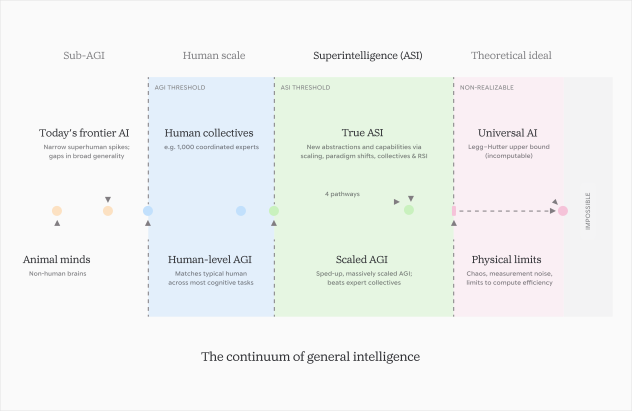 随着AGI临近,AI可能向人工超级智能(ASI)推进——这类系统在大多数任务上能以更少资源持续超越大型专家群体。智能处于连续谱上,理论极限远超人类。即使没有新突破,认知工业化——有效算力、算法效率和硬件投资的快速增长——也可能将AI的速度与规模扩展到足以产生弱ASI并使认知工作商品化。还有四条额外路径可能解锁新能力:模型与数据扩展(面临数据枯竭、收益递减和资源限制);技术范式转变(解决持续学习、世界建模、样本效率和新概念发明);改进的智能体协调(在管理错误信息、操控和串谋的同时创造集体智能);以及递归自我改进(AI自动化改进代码、数据或专门的智能体集合)。这些路径会相互叠加,因此限制某一个领域不太可能阻止进展,还可能造成能力超前积压。总体而言,它们使快速迈向ASI成为一种严肃可能性,具有重大的科学、经济和社会影响。准备需要大规模跨学科努力,利用前沿访问权限、评估算力和新基准来建模、衡量和预测进展。
该帖讨论 DeepMind 关于 AGI 之后的内容。许多评论者拒绝将当前 LLM 称为 AGI,认为统计模式匹配缺乏理解、持续学习、好奇心和真实世界能动性。其他人更务实地将 AGI 定义为完成大多数人类任务,并认为当前模型已达到或接近该标准。讨论质疑 AGI 是否是一个有用术语,有些人更偏好 ASI 来表示远超人类的能力。反复出现的主题包括语言模型与物理/世界交互之间的差距、自我导向学习的需求、对扩展和新架构的不确定性,以及失业、不平等和安全等社会影响。有些人将 AI 视为通信或自动化工具而非真正智能,而另一些人则认为它具有变革性且已具经济力量。总体而言,对定义和时间线没有共识,但普遍同意标签不如实际能力和后果重要。
 Ira Lewis Velinsky(1954–2000)是一位工业设计师,因在 Commodore 和 Atari 的工作而知名。他设计或 credited 了多款计算机机壳,包括 Porsche PETs、TED/Plus/4、Commodore MAX 和 SX-64 以及 Atari ST;他的讣告将原始 Commodore 64 机壳归功于他,但一些历史学家认为它属于另一位设计师。他于 1980 年代初加入 Commodore,后来跟随 Jack Tramiel 到 Atari 担任工业设计总监,并可能曾为 Sega 提供咨询。他还设计了 DEC Rainbow 机壳,并于 1998 年创立 Sozo Design LLC。早年,他在 RIT 和康奈尔大学学习,曾在城市规划部门实习,并设计了消防装备整合。Velinsky 在从 Comdex 返回途中因心脏病发作去世,享年 46 岁。他是一位低调的人物,公开信息有限。
对不起。
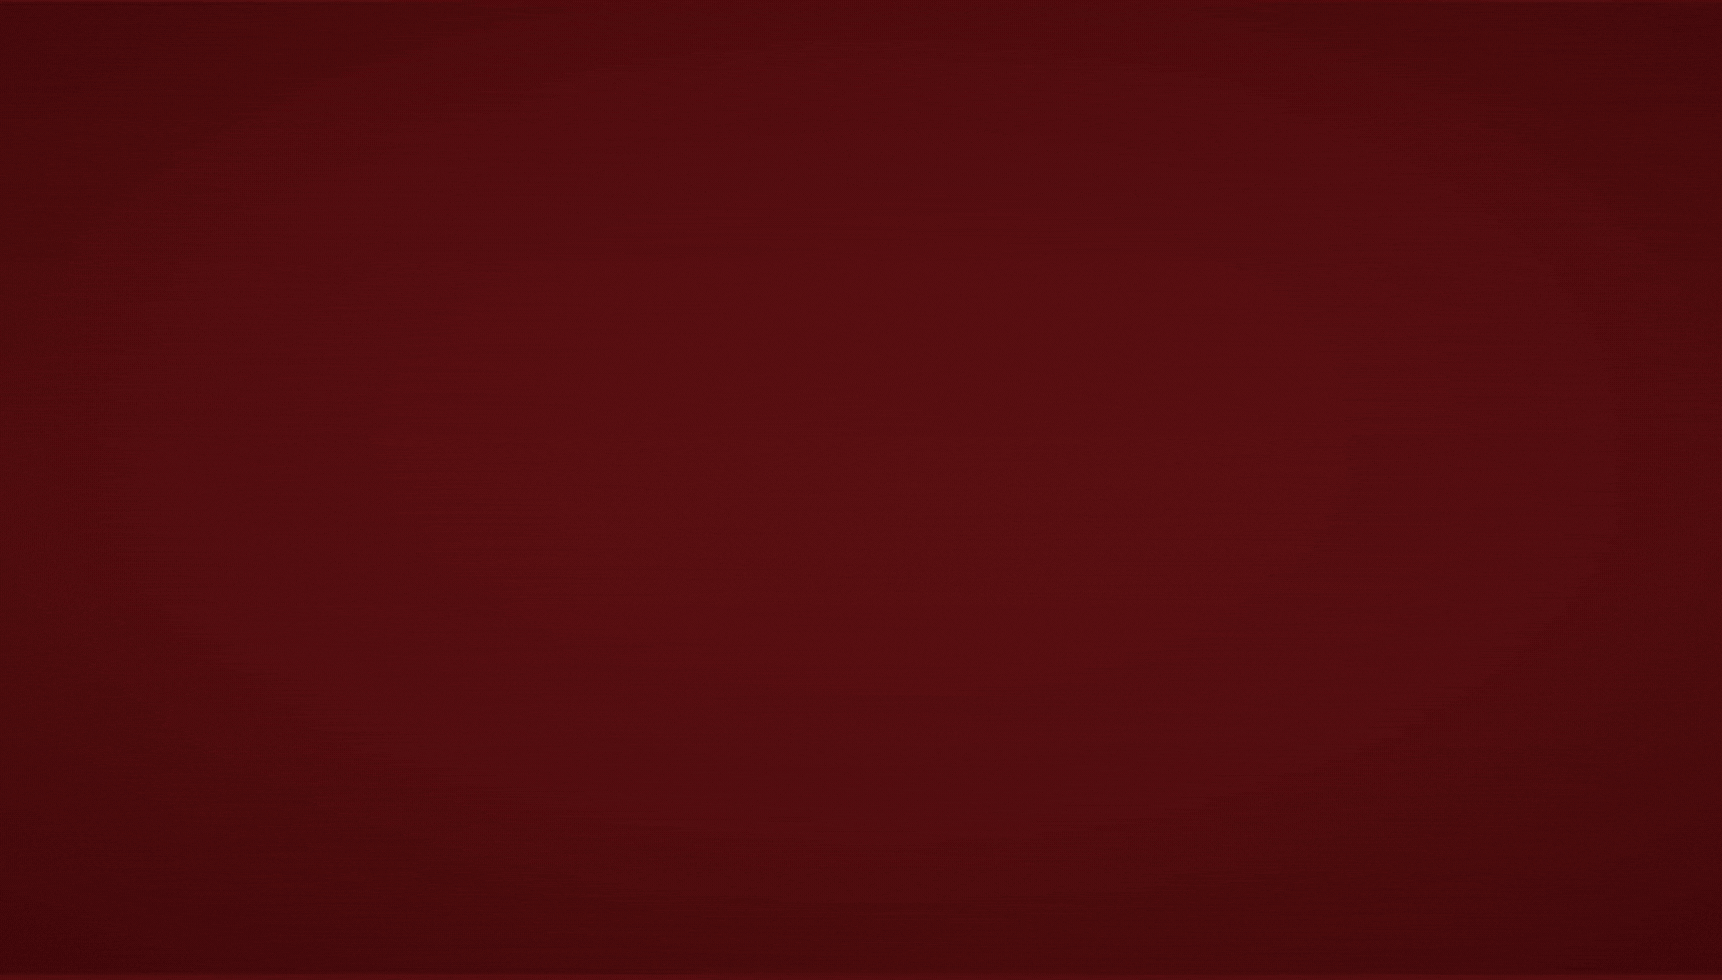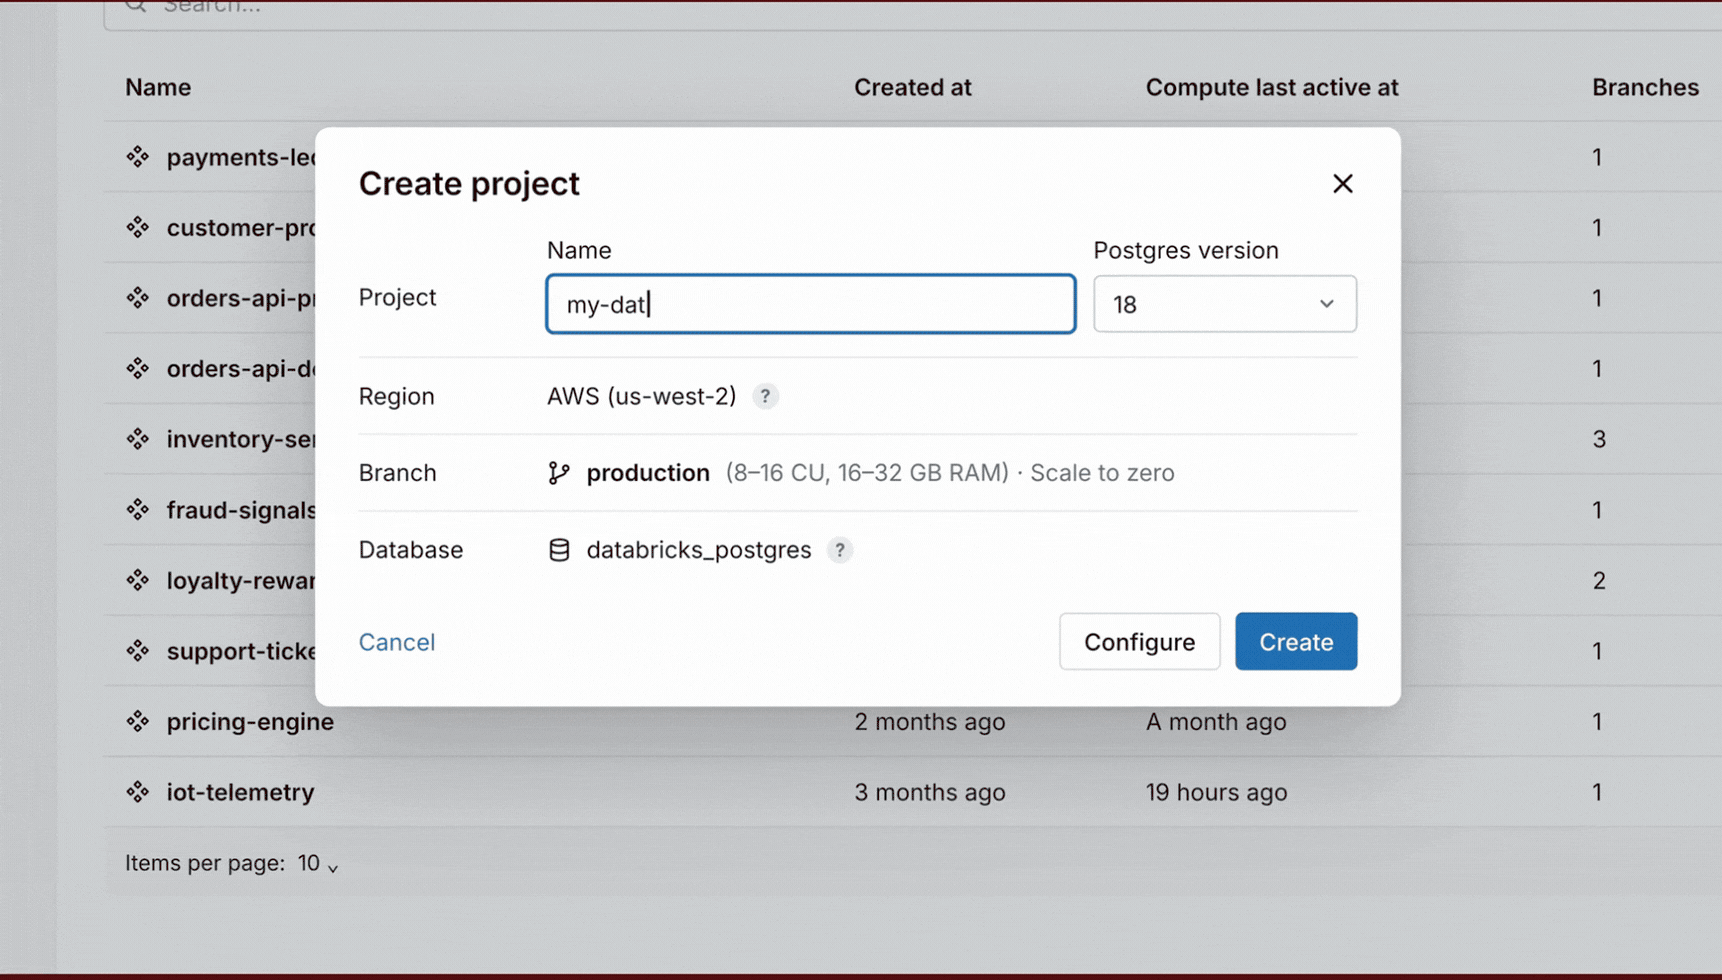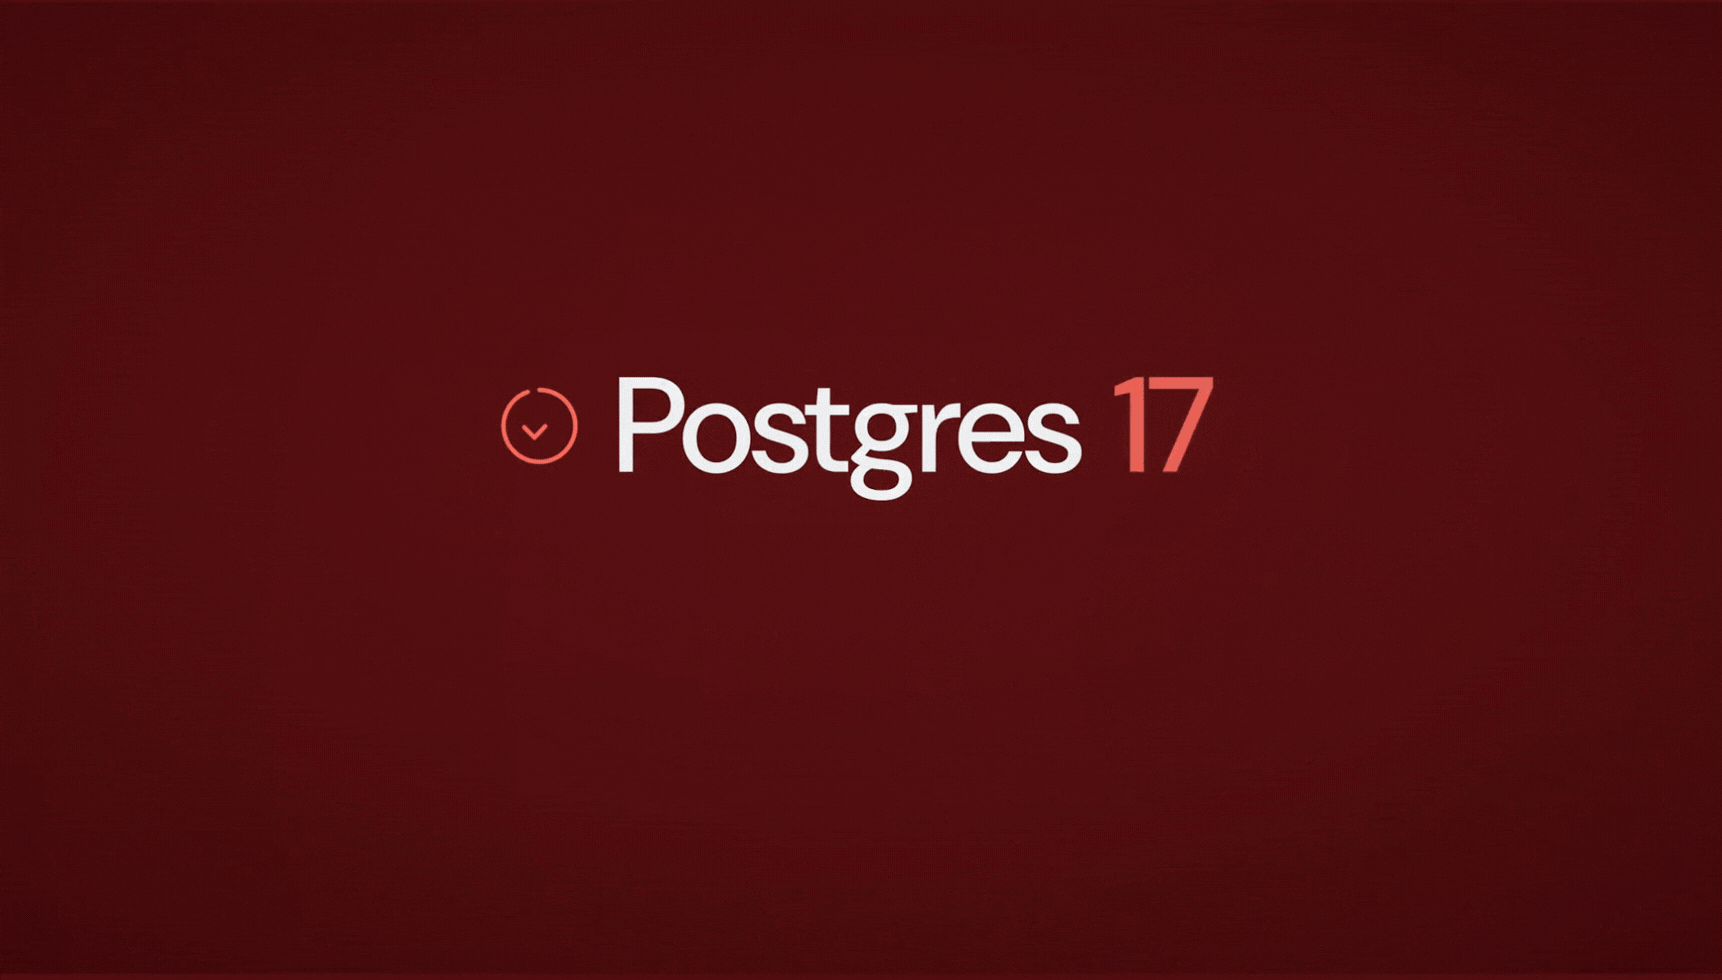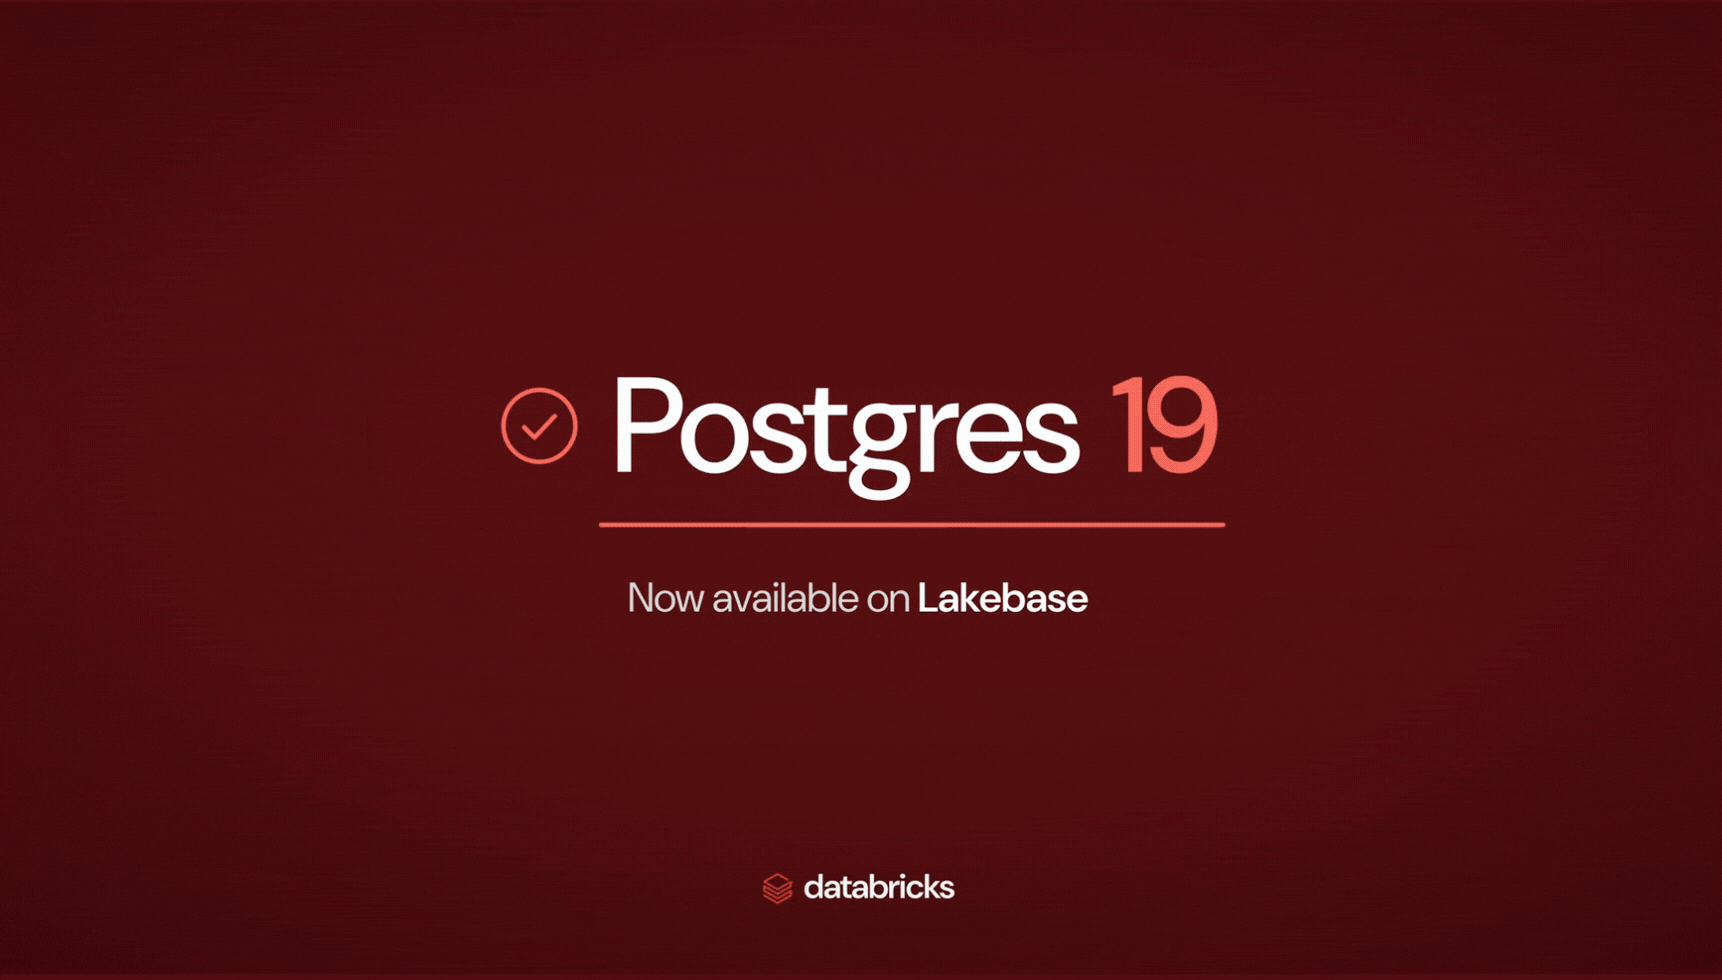 PostgreSQL 19 现已正式发布(GA),可在 Lakebase 上使用。其聚焦运维控制:REPACK 在有限锁定下回收空间;pg_plan_advice 和 pg_stash_advice 稳定查询计划;并行 autovacuum 和新的统计视图改善维护与诊断;逻辑复制新增序列同步、更广泛的发布选项和 postgres_fdw 服务器复用;WAIT FOR LSN 帮助协调副本的读己之写;postgres_fdw 可导入远程统计信息;ON CONFLICT DO SELECT 支持 get-or-create;COPY TO 可输出 JSON。其他改进包括 JSON 路径字符串方法、随机日期/时间函数、IGNORE NULLS 窗口选项、自动 I/O 工作进程扩展以及更快的外键检查。部分计划功能被移除,多项默认值发生变化,且并非所有扩展都已可用。用户应在生产升级前测试工作负载与扩展;PostgreSQL 19.1 预计在二月左右发布。
Postgres 19 已在 Neon 和 Databricks Lakebase 上可用。Hacker News 评论者将 REPACK 列为最受欢迎的新功能,回忆起 Reddit 的 vacuum 问题。其他人指出性能改进并等待 AWS。对 Snowflake/Databricks 同时发布及可能的员工刷票存在怀疑;一名评论者指称 Snowflake 的社交媒体营销活动。Neon 讨论将其解释为支持缩容至零和分支的无服务器 Postgres,已被 Databricks 收购;用户称赞其稳定性。有些人偏好官方公告链接。总体而言,对 PG19 的兴奋,尤其是对 REPACK 的兴奋,与对厂商推广的担忧交织在一起。
作者推出了 Future Stories,一档关于技术、科学以及我们如何生活的播客。第一集的嘉宾是 TCP/IP 的共同创造者 Vint Cerf。83 岁的 Cerf 最近离开 Google,正在帮助开发 Tolero——一款面向星际互联网的软件,并称“光速太慢了”。亮点包括合作者 Steve Crocker 在三十秒内解决了一个困扰两周的 bug;CERFnet 的 glitter-bottle 发布;以及他试图将 Minitel 连接到 MCI Mail 的失败尝试。Cerf 还简要讨论了 AI,展示了 1969 年的 ARPANET 接口消息处理器铭牌,并警告说,22 世纪的读者可能无法解读今天的数字记录。这一集时长 56 分钟,包含章节和文字稿,短视频片段即将推出。该项目旨在讲述持久的故事;听众可以订阅并推荐未来的嘉宾。
黑客新闻上的一个帖子讨论了文特·瑟夫的解释:TCP/IP 未申请专利,因为它被设想为用于指挥控制系统和未来盟友的开放底层;开放性和互操作性被放在首位。评论者指出 TCP/IP 仍属未完成状态,32 位 IPv4 地址本意是临时方案。帖子分支扩展到更多未申请专利的技术(UTF-8、Linux、HTTP 等)、专利争论以及关于瑟夫的逸事。有人讨论现代创新是否过于关注变现,也有其他人援引近期开放标准。还有关于图书馆、疫苗和瑟夫在 Google 角色的旁支讨论。总体而言,评论强调了开放性、互操作性,以及不对基础互联网协议申请专利所留下的深远影响。
这修复了 `EVP_EncodeBlock()` 中的缓冲区溢出(CVE-2026-121481),方法是对无效输入返回 `-1`。它还为 `EVP_DecodeBlock()` 提供了类似的防护,并修复了 `http_client.c` 中 `base64encode()` 函数的错误长度检查。还更新了文档并添加了新测试。
一个 OpenSSL CVE(2026-121481,CVSS 9.8)报告 EVP_EncodeBlock 在编码接近 INT_MAX 的超大输入时存在缓冲区溢出,允许写入超出调用方提供的输出缓冲区。评论者指出该 API 设计不佳,因为调用方必须计算输出大小,而 OpenSSL 无法验证。该问题主要影响 OpenSSL 4.x;大多数发行版仍停留在 3.x,而 Arch/Fedora 已经升级到 4.x。讨论质疑 CVSS 严重程度,认为实际可利用性取决于不可信输入是否能到达该函数以及调用方如何使用它。更广泛的辩论涵盖 OpenSSL 长期以来的代码质量、开源基础设施的资助与许可、LibreSSL/BoringSSL/AWS-LC 等分支、Rust 替代方案以及漏洞疲劳。一些评论者主张需要更好的 API 和更安全的语言;其他人则警告不要对理论 CVE 过度反应。总体而言,该讨论将此视为一个严重但依赖上下文的 bug,以及更广泛软件安全挑战的症状。
权重空间编程像1990年代的研究者一样构建神经网络 Weight-Space Programming builds neural networks like a 1990s researcher
2 天前
 权重空间编程让大语言模型直接设定神经网络权重。在严格的MNIST实验中,Claude Fable 5.2手工地构建了1990年代风格的流水线——边缘检测器、数字模板、环路/角点/笔画特征,然后测量特征出现率并构建朴素贝叶斯分类器——达到约91%的测试准确率,与50步Adam训练相当。在猫狗分类任务中,手工设计的照片属性达到61.6%,低于更强的Adam训练。原始Go网络同样将经典基于规则的围棋逻辑编译进权重,使用气、提子、眼、劫处理和调优常数;对弈练习改进了规则和参数。总体而言,大语言模型擅长在反馈下串联与测量经典技术,但结果反映的是手工设计的特征,而非新的训练方法。更难的问题暴露了这种方法的局限。
对不起。
在一次 AMD 深度访谈中,Mahesh Subramony 讨论了 EPYC Venice/Zen 6 SoC 设计。AMD 采用 2.5D 封装,在 CCD 与 I/O die 之间以低功耗传输 1.6 TB/s;短链路要求匹配 die 间距,这促使将 I/O die 拆分为两个。AMD 使用一个镜像 I/O die 设计,其中部分单例模块被重复,并需确保镜像 fabric 域表现如单个 SoC。SP7 和 SP8 使用不同的 I/O die:SP7 面向更高计算/内存带宽,SP8 提供 128 条 PCIe 通道和更少内存通道。12 核 CCD 有三条 I/O 链路,以在较低核心数下饱和 MRDIMM 带宽;32 核 CCD 有四条链路。32 核 CCD 包含一个冗余的第 33 个核心/缓存切片,用于良率回收,同时保持 32 个活跃核心和简单 mesh 拓扑。更大的 128MB L3 增加几周期查找延迟,但应提高命中率。密集型 32 核 CCD 近期不太可能获得堆叠 V-Cache;AMD 优先考虑带宽/频率。
对不起。
该文本比较了19个AI模型的指数分数、提供商以及相对成本/令牌用量。Neon排名最高(69.5),其次是Fable 5.2、Opus 5.5和6.2 Astra;Luna排名最低(34.8)。它还显示了相对于基线的成本和令牌倍数,并比较了选定模型在包括CursorBench、FrontierCode、Code Migration、IOI、ProgramBench、Terminal-Bench和Vibe Code等编码/智能体基准测试中的表现。基准分数因模型和任务而差异很大。数据归因于Cognition、Cursor、Laude Institute和Vals AI,来源在GitHub。
Hacker News 用户讨论 Gemini 4 Neon 在一个自提交的 Models Engineering Index 中排名第一。许多用过它的评论者称赞其编程、文档、艺术和清晰沟通,称其可与 Opus 5.5/Fable 抗衡甚至更好,同时感觉更快更便宜。用户将 Google 订阅与 Anthropic/OpenAI 套餐有利对比,但访问、配额和 harness 限制让很多人沮丧。一些人批评该基准不完整或有误导性,指出 Neon 的基准结果比 Fable 少。其他人报告了混杂的真实世界结果,包括回归、拒绝和速率限制,并质疑 Google 的命名和发布。总体而言,有权限用户的整体情绪较为正面,但关于价值、可用性以及模型早期强印象是否能持续的争论仍在继续。
Visa、Mastercard和JPMorgan客户数据遭黑客泄露 Visa, Mastercard and JPMorgan Customer Data Leaked by Hackers
3 天前
请启用 JS 并禁用任何广告拦截器
黑客据报泄露了与Visa、Mastercard和JPMorgan相关的客户数据,据称来自一家第三方营销服务。暴露的信息似乎包括约1.6万名客户的姓名和电子邮件地址;一个非付费墙来源称,摩根大通富裕持卡人的电子邮件和电话号码被勒索软件组织n0n发布。Hacker News评论者争论这些数据与银行对账单相比价值是否较低,同时指出其仍可能引发敲诈、声誉损害和缓解成本。讨论还关注客户是否为第三方数据共享给予了知情同意、管控众多供应商的困难以及对数据泄露问责的薄弱。一些评论者认为消费者对数据泄露已麻木,而另一些人则呼吁更严厉的处罚或更注重隐私的客户联系方式。总体而言,该帖将此事件视为第三方数据处理风险的又一例。