 1692年,艺术家 A. Boogert 创作了《Traité des couleurs servant à la peinture à l’eau》(荷兰语:《Klaer Lichtende Spiegel der Verfkonst》),这是一部900页的水彩手册。书中包含700多页色样,早于现代色彩理论,采用的是亚里士多德的体系,而非牛顿的光谱。此书仅制作了一册,很可能是为了教导水彩画家;几乎没有证据表明它影响了当时的色彩理论。历史学家 Erik Kwakkel 在法国的一个数据库中发现了它,并指出它为了解17世纪画家的工作室提供了罕见洞见。该书藏于普罗旺斯地区艾克斯的 Bibliothèque Méjanes,网上有可缩放的扫描件。其类似潘通色卡的色块令人惊叹,但 Boogert 的体系很快就被取代;又过了一个世纪,歌德、Werner,并最终是潘通,才推动了色彩标准化。这本手册仍是荷兰黄金时代的一件特殊文物。
每日HackerNews RSS
Hacker News 的一个讨论串重点提到一本1692年的900页荷兰色彩指南《Klaer Lightende Spiegel der Verfkonst》,作者是 A. Boogert,可通过 Open Culture 获取完整高分辨率扫描版。评论者称赞这件潘通之前的文物,以及相关作品,如 Werner 的《Nomenclature of Colour》、歌德的色彩理论和《Nature’s Palette》。他们讨论书中手绘色样、教学用途和令人惊讶的鲜艳程度,同时质疑它是否可能被印刷过,以及扫描件再现原始颜色的准确度。话题转向长s字体排印、颜料耐久性、群青成本、显示器校准,以及潘通在色彩标准化中的作用。有人推荐 ColorNerd 和旧版潘通色卡册。总体而言,这个讨论串赞美历史色彩参考资料以及扫描背后的努力。
该应用会一次性下载 AI 模型(约 2.9 GB)。最大的模型(2.5 GB)会校验与金钱相关的回答,并可在“设置”中禁用。唯一另一项请求用于检查并下载应用更新;它不包含个人数据,也可以禁用。不会发送其他任何内容。 同步时,应用会调用 Pulse,Pulse 向 Plaid 请求新交易,并在同一响应中返回它们。交易数据会经过服务器内存,但不会被存储。服务器只保留连接令牌和记录:机构、状态和上次同步时间。完整详情见隐私页面。你的账本、模型和每个问题都保留在你的设备上。
Show HN:Pulse Local 是一款免费的 Mac 预算应用(Apple Silicon 测试版),在本地运行 AI。在本地模式下,无需账户;账本和提问都留在设备上,无分析。用户可导入任意货币的银行 CSV。经过调优的 Qwen3 0.6B 模型将问题转换为结构化查询;代码执行金额计算,4B 校验器验证答案,将 494 个问题中的错误减少到 5 个。首次启动下载约 2.9GB;校验后的答案耗时 12–14 秒。仅英文、仅 Mac,Windows 计划中。可选 Connected 模式(29 美元/年)通过 Plaid 同步美国银行。HN 反馈称赞本地优先的隐私保护,但批评 CSV 导入、UI 漏洞、手动分类、模型下载大小和设置摩擦。开发者已发布 0.4.1 修复版,并计划支持 PDF 解析和国际银行集成。评论者还建议 SimpleFIN、Actual Budget,并质疑预算管理是否需要生成式 AI。
休闲编程是出于乐趣和好奇心写代码,不为工作、金钱或外部要求。它意味着探索新语言、构建“无用”工具、解决自己发明的问题,并跟随精力而非计划。它不是副业、职业苦熬、教程或面试准备。常见风格包括实时探索者、深度钻研者、创意技术者、问题解决者和语言探索者。无论哪种风格,关键做法是:允许自己构建没有投资回报的东西,兴奋消退时就切换,记录过程,并重视学习胜过发布。建立一个低压力的实验空间,尝试每周实验、玩具式构建、解痒项目、教学项目或跨语言挑战。从“我应该”转向“如果……会怎样”,把好奇心置于生产力之上。Tsoding、Casey Muratori、Ben Eater 和 Dan Luu 等例子展示了回归编程乐趣的多样路径。挑战是:选一个小实验,花两小时在你好奇的事情上,如果不再有趣就停下。目标不是成为著名的休闲编程者——而是记住你当初为什么开始编程,并让那份好奇心保持活力。
NEXUS-Q 尚未达到生产就绪状态。它是一个具有强大 CI 的工程项目,但没有独立的外部审计或认证;GitHub 发布并不意味着经过审计。V1 优先考虑正确性与安全性,实测比最快的实现慢约 2–4.5 倍。V3 保留清零/加固,并接受这一代价;V4 计划进行 AVX2/NEON 优化,仅在严格验证后才默认启用。它将 ML-KEM 与 X25519 组合为混合方案,因此只要任一方案仍然成立,密钥交换就仍受保护。该仓库包含一个 C SDK 以及 Python、Go、PHP 和 Ruby 绑定,全部从源代码构建,未发布到软件包注册表。它采用 MIT/Apache-2.0 双许可。为提供帮助,请阅读威胁模型、运行 Arena、审查代码,并提交 issue/PR。性能工作跟踪于 Issue #23;安全报告通过 GitHub 安全公告提交。
Physical Intelligence 于 2026 年 10 月 13 日推出 Pi API 测试版,使其最新的机器人基础模型可用于训练和托管推理。开发者可以上传数据,在托管基础设施上微调 π 模型,并通过托管网关运行微调后的模型。目标是简化通用机器人模型的适配,减少机器学习基础设施和数据管道的负担,同时实现端到端自主性。早期合作伙伴测试了多种任务和硬件,包括 Actor 的自主轮式装载机和 Almond 的 Axol 双臂机器人,后者经过四天的 API 迭代后学会了去除垫片毛刺。该工作流支持独立迭代:收集演示、训练、在机器人上测试,然后利用失败来指导新数据。反馈将改进未来模型并推动通用物理智能发展。该测试版开放申请。
在 Hacker News 上,一篇题为“Physical Intelligence API Beta:面向每台机器人的前沿模型”的帖子(52 分,4 条评论)引发了讨论。评论者认为,要求通过 API 调用来操作关键任务机器人,根本行不通。有人建议采用边缘/云混合模型——系统 1 在边缘,系统 2 在云端——并指出 Physical Intelligence 可能很适合这种模式。另一人提出了知识产权保护方面的担忧:如果有人转储磁盘或内存,就能获取 LLM 权重,那么云厂商如何防止这种情况?他们想知道,Anthropic 是否相信 AWS/Google 不会窥探,以及人们是否真的信任马斯克。一个幽默回复提议,把权重装在一个类似 AWS Snowball 的公文包里,并让一名武装警卫用手铐把自己和它铐在一起。总体来看,该讨论串质疑了机器人对云的依赖以及模型安全。
阿尔法NIST AlphaNIST
27 天前
试图规定每一个动作,意味着要预判机器人在接触和障碍变化时应如何反应。两指夹爪可能也需要与人类手部自然采用的方案截然不同的解决方案。也许答案是不再告诉机器人我们认为任务该怎么做,而是让它学会如何达到目标。我们为成功给它一个二元任务奖励,并通过大量多样化的经验来训练它。这就为机器人留出了空间,去发现我们可能从未想过要教的解决方案。
 在《撰写文档:2026 年版》中,作者反思了实现决策记录(IDR)。IDR 原本旨在改善 LLM 输出并保留实现决策。但在提示模糊时,LLM 往往只是重述其计划的实现,使 IDR 变得有损,并不比 diff 更好。一个 DuckDB 序列化 IDR 含糊且无用;一个 PyPI GitHub Actions IDR 效果更好。它有清晰的问题陈述、目标、非目标,以及一个不包含实现细节的简短建议方案。作者得出结论:有效的 IDR 必须不断回归意图和决策;否则它们只是用英语重述 diff。清晰、有力的 IDR 也能更好地引导 LLM 行为,而细节可以在 diff 中找到。
Hacker News 上的一场讨论审视了“IDR 作为意图记录”。评论者认为记录实现决策有价值,但对其长期维护争论不休。有人指出,随着代码变化,IDR 列表会变得庞大,并不可避免地过时、相互矛盾或产生误导;由于 IDR 记录的是 LLM 无法推断的信息,LLM 无法可靠判断它们是否仍然适用。管理它们需要索引/主题组织和持续的文档维护。另一位评论者使用类似的前置 PLAN.md,在编码前批准,之后丢弃。他们定义了“评审面”,例如公共 API 和数据库模式,未经评审不得更改。第三位强调,持久的意图记录至关重要:未来的开发者常会问,为什么会做出某个奇怪选择,而记录推理和先前尽职调查有助于判断何时应重新审视某项决策。该讨论串的结论是,决策记录很有价值,但需要积极维护。
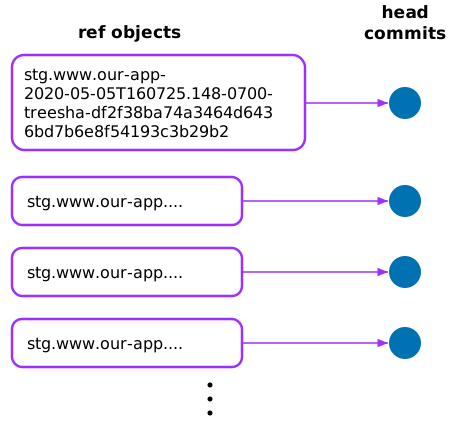 为避免成千上万的发布标签拖慢 Git 并弄乱 refs,作者提议将部署记录为按(层级,应用)组织的元信息提交链。每次新发布都会创建一个双父提交:第一个父提交是上一个元信息提交,第二个是本次部署的提交。一个 ref,例如 `stg.www.our-app`,指向最新的元信息提交。其创建时间记录发布时间;提交信息/树可保存元数据。普通 Git 命令便可自然使用:`git log stg.www.our-app` 列出发布历史,`~n^2` 定位更早部署的提交,回滚/差异比较也很容易。这样每个应用/层级只保留一个 ref,避免 packed-refs 变慢,并像普通提交历史一样扩展。该提议未被采纳,可能存在未预见的缺点。
Hacker News 用户回应“也许有更好的方式来跟踪 Git 仓库的发布历史”。所提议的方法被认为复杂且不直观。评论者提出了更简单的替代方案:发布时合并到发布分支;将部署清单保存在单独仓库中并由自动化更新;向 main 提交一个发布标记文件;或者使用标准 Git 标签表示版本,并据此发布构建产物。一个注意事项:Git 标签并非真正不可变——它们只是在约定和默认工具下不可变。其他人质疑为什么要保留旧的 ref,尤其是每次预发布,因为那段历史往往没用。总体而言,该讨论帖更支持传统、轻量的发布跟踪方式,而不是向项目仓库添加许多与源代码无关的 ref。
检方称,OpenAI 工程师、35 岁的沙特阿拉伯籍人士 Abdulrahman Alfozan 于周五被捕,并被控截取口头通信。此前,在 OpenAI 旧金山总部,一个加密录音设备被发现藏在卫生纸中,并插在会议室的一台电视上。该设备于 9 月 30 日被发现。据称,监控录像显示 Alfozan 曾出现在该房间附近,检方称,一个与他配偶关联的聊天机器人账户曾研究录音、加密和远程访问。据称,第二个设备在一个无人看管的包里被发现,包内还有他的身份证件。Alfozan 在 OpenAI 产品团队工作,于周五被解雇。如果被定罪,他面临最高五年监禁和 25 万美元罚款。OpenAI 和 FBI 称此案是国家安全和 AI 创新的优先事项;OpenAI 表示,没有模型权重、源代码或客户数据遭到泄露。拘留听证会定于 10 月 19 日举行。
OpenAI 工程师阿卜杜勒拉赫曼·阿尔福赞因涉嫌在一间高管会议室安装录音设备而被捕。该设备是一台基于 ESP32 的录音器,藏在电视机后面的卫生纸里,并插在 USB 上。检方称,一个与他配偶关联的 ChatGPT 账号询问了如何制作、安装、加密并远程访问录音器,还提到了该设备的 MAC 地址。OpenAI 在一次排查中发现了它,加装了一个摄像头,随后拍到阿尔福赞查看电视机后面。他被解雇,并被控试图截取口头通信;FBI 称此事涉及国家安全。HN 评论者嘲笑其谍报手法拙劣,指出聊天机器人日志是可被调取的证据,讨论隐私与本地 LLM,并开玩笑称 OpenAI 用自己的模型来调查。一些人推测是内幕交易或与国家有关联的间谍活动,但尚无证据得到证实。
PostEra(YC W20)正在招聘药物发现领域的人工智能研究员 PostEra (YC W20) Is Hiring AI Researchers for Drug Discovery
27 天前
PostEra 是一家以 AI 为先的生物科技公司,利用其 Proton 平台进行药物化学,正在招聘一名机器学习研究员,以发展其智能体研究垂直领域。该职位聚焦智能体系统,用于自动化生物化学/生理过程的机制模型、用于靶点验证的生物数据分析,以及少样本适应、分子/表格上下文学习和基于专有多模态数据的基础模型的机器学习方法。职责包括领导研究、基准测试、训练/扩展模型、构建可复现流程、与化学家和生物学家合作,以及发表成果。要求:机器学习或 STEM 博士学位,并有新颖的机器学习研究;扎实的机器学习/深度学习/统计学能力;精通智能体科学工作流、生物信息学/临床建模、上下文/表格/少样本学习;熟悉 PyTorch/JAX;能够定义模糊问题、设计严谨实验,并适应初创公司工作。加分项包括表格基础模型、分子上下文学习、大规模/分布式训练、AI 联合科学家系统、生物/临床机器学习,以及模型生产化。薪资 20 万–30 万美元,股权 0.05–0.1%;不提供签证担保。
Hacker News
最新
|
过往
|
评论
|
提问
|
展示
|
招聘
|
提交
登录
PostEra(YC W20)正在招聘药物发现领域的人工智能研究员
(
lever.co
)
1天前
|
隐藏
考虑申请 YC 2027 年冬季批次!
申请
开放至11月2日。
指南
|
常见问题
|
列表
|
API
|
安全
|
法律
|
申请 YC
|
联系
搜索: